Linux
10 phút•28/10/2026
Kết nối SSH bằng key và cấu hình truy cập an toàn
Tạo SSH key từ Windows, Linux hoặc macOS, xác minh host key và kiểm tra phiên đăng nhập mới trước khi hạn chế đăng nhập mật khẩu trên Ubuntu Server.
GuideĐọc ngay
Lọc log Linux theo service, thời gian và boot; phân biệt lỗi gốc với thông báo hệ quả, kiểm tra quyền đọc và xác nhận phục hồi sau khi sửa nguyên nhân.
Khi dịch vụ không chạy, việc restart liên tục thường chỉ tạo thêm log. Cách hiệu quả hơn là xác định lần lỗi nào cần xem, tiến trình nào phát sinh bản ghi và thay đổi gì xảy ra trước đó. Bài này dùng journalctl trên Ubuntu Server 24.04 LTS để đi từ một triệu chứng tới bằng chứng có thể kiểm tra lại.
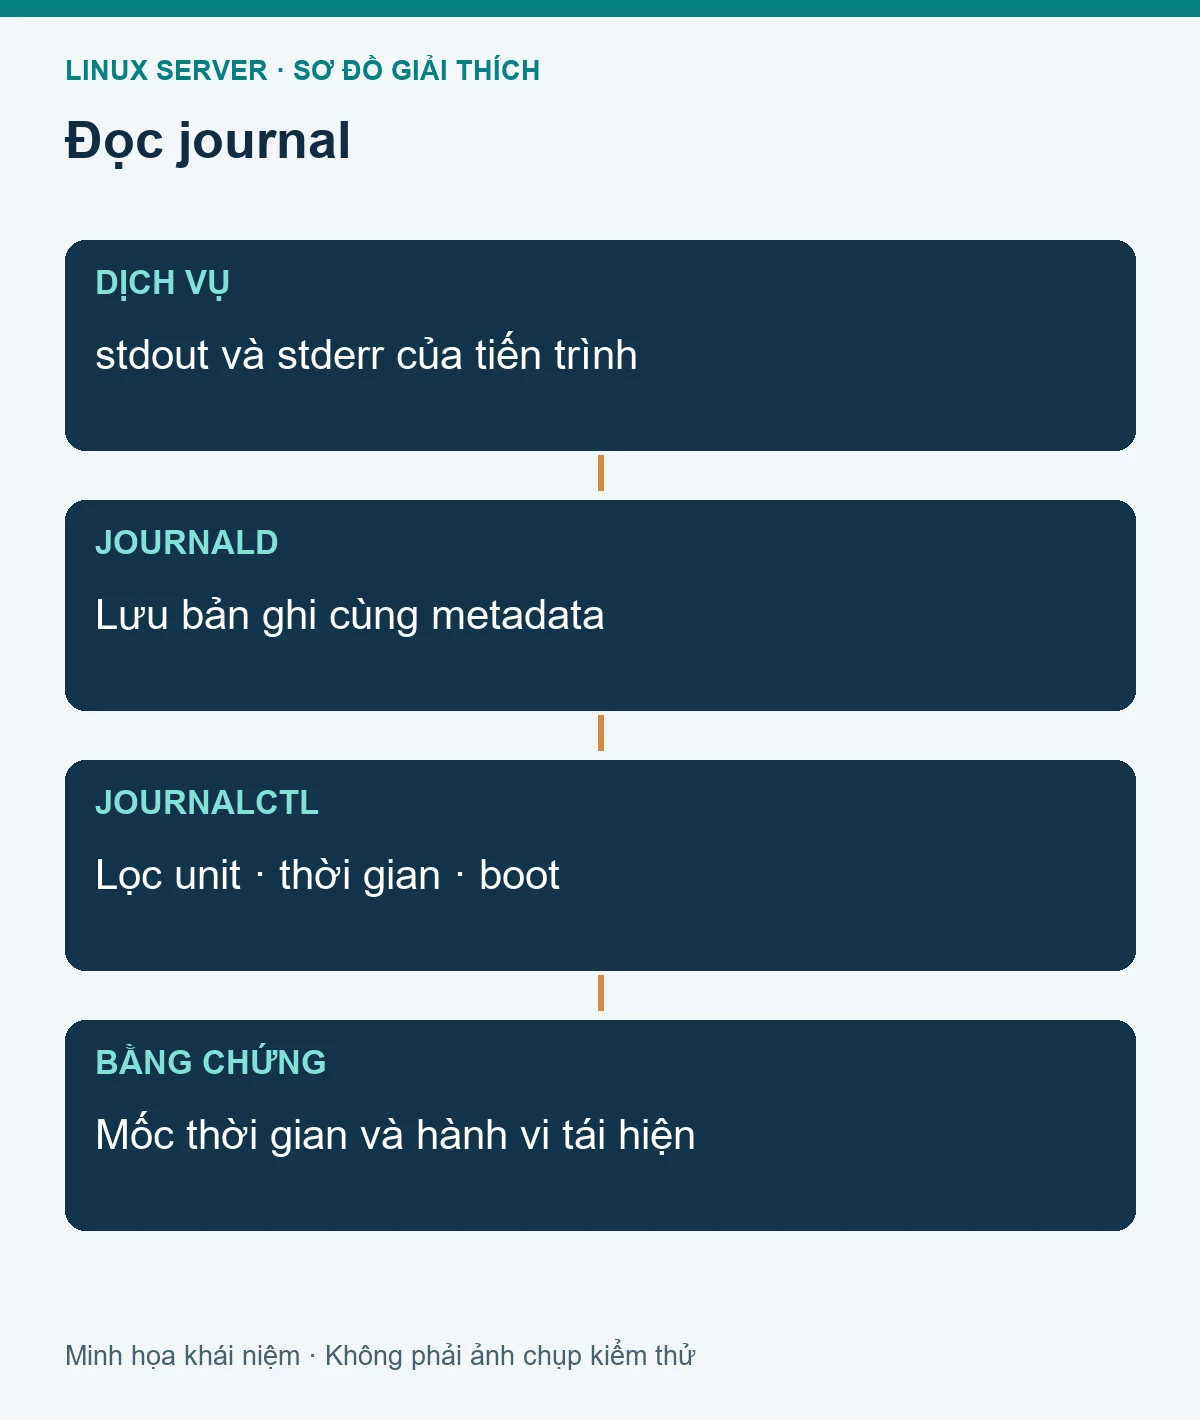
systemd-journald thu thập nhiều loại bản ghi, trong đó có stdout/stderr của service do systemd quản lý và thông điệp kernel. Bản ghi có metadata như unit, PID, priority và boot ID, giúp lọc theo bối cảnh. Không phải mọi ứng dụng đều đưa log vào journal; một số ghi file riêng, gửi log đi xa hoặc dùng hệ thống logging khác.
Vì vậy, không thấy lỗi trong journal chưa chứng minh ứng dụng không có lỗi. Xem cấu hình logging và tài liệu phần mềm trước khi chọn nguồn. Một web server có access log và error log riêng có thể chỉ gửi phần thông báo vòng đời service vào journal.
Tài liệu journalctl chính thức mô tả bộ lọc và quyền truy cập. Trang tài liệu upstream có thể mới hơn systemd trên Ubuntu 24.04; kiểm tra journalctl --version và man journalctl trên máy trước khi dùng tùy chọn ít phổ biến.
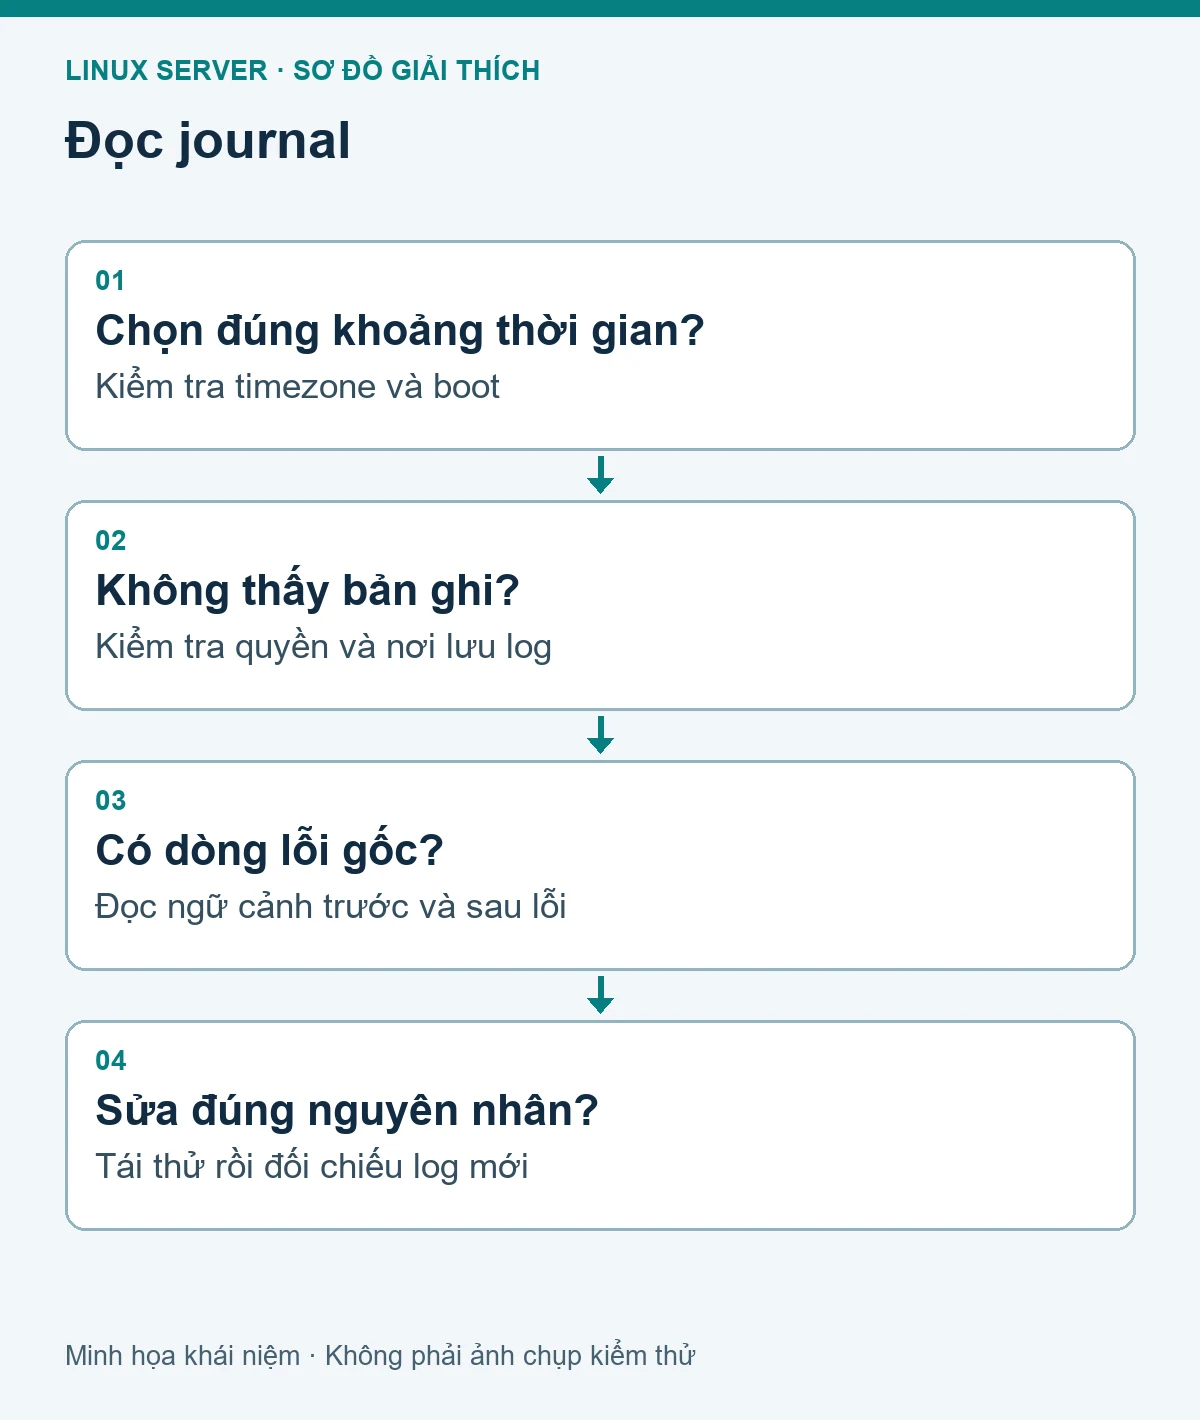
Hỏi rõ lỗi xuất hiện khi nào, timezone nào, tác động tới thao tác gì và có thay đổi cấu hình hay cập nhật trước đó không. Một báo cáo “server lỗi sáng nay” cần được chuyển thành khoảng thời gian đủ hẹp để đối chiếu.
timedatectl status
systemctl status lab-web.service --no-pager
sudo journalctl -u lab-web.service --since '-15 minutes' --no-pager
Ví dụ dùng service lab ở bài systemd. Thay tên unit bằng unit thực tế đang điều tra. --no-pager thuận tiện khi lưu đầu ra; nếu đọc tương tác có thể giữ pager để tìm kiếm và cuộn. Khi log dài, không dùng tail quá ít dòng rồi bỏ mất ngữ cảnh ngay trước lỗi.
Nếu tên unit không chắc chắn, dùng systemctl list-units --all và systemctl list-unit-files. Phân biệt unit hệ thống với unit của người dùng; journalctl --user không hoàn toàn tương đương sudo journalctl -u ....
sudo journalctl -u lab-web.service -n 50 --no-pager
sudo journalctl -u lab-web.service --since '2026-10-28 09:00:00' --until '2026-10-28 09:15:00' --no-pager
sudo journalctl -b -p warning --no-pager
sudo journalctl --list-boots
sudo journalctl -b -1 --no-pager
Ngày trong ví dụ phải thay bằng khoảng thời gian sự cố; đừng sao chép rồi kết luận không có log. Mặc định thời gian hiển thị theo quy tắc của công cụ và timezone máy. Khi phối hợp nhiều server, thêm --utc để thống nhất cách trình bày rồi ghi rõ UTC trong biên bản.
-b chọn boot hiện tại; -b -1 chọn boot trước nếu còn dữ liệu. Không có log boot trước có thể do journal lưu tạm, đã rotate hoặc máy mới tạo, chưa đủ bằng chứng rằng lần boot đó không có lỗi.
-p warning bao gồm warning và các mức nghiêm trọng hơn. Đây là bộ lọc giúp giảm nhiễu, không phải đánh giá tự động mức tác động. Một ứng dụng có thể ghi lỗi quan trọng ở mức info hoặc không đặt priority phù hợp, nên quay lại log đầy đủ quanh thời điểm cần thiết.
Mở một terminal để theo dõi:
sudo journalctl -u lab-web.service -f
Trong terminal khác, gửi một yêu cầu vào service mẫu và ghi lại giờ thực hiện. Dừng theo dõi bằng Ctrl+C chỉ thoát journalctl, không dừng service. Theo dõi trực tiếp giúp ghép thao tác với bản ghi nhưng không thay thế việc lưu lại khoảng log cần thiết sau đó.
Không tái hiện bằng cách gây tải lớn hoặc làm hỏng dữ liệu trên production. Với sự cố có nguy cơ ảnh hưởng người dùng, lấy log hiện tại, tạo lab phù hợp và thống nhất cửa sổ kiểm tra. Một HTTP request thử chỉ nên dùng endpoint an toàn, không tạo giao dịch hoặc gửi thông báo ngoài ý muốn.
Ở lab, service lab-web.service có thể được đặt tạm một đường dẫn binary không tồn tại. Sau khi restart có chủ đích, systemctl status thường báo failure, còn journal cung cấp chi tiết bước không thực thi được. Mục tiêu bài tập là tìm thông điệp gốc trước chuỗi thông báo restart lặp lại.
Quy trình điều tra:
systemctl cat với đường dẫn trên filesystem.Không mô tả mọi thông báo Failed là nguyên nhân. “Start request repeated too quickly” có thể là hệ quả của những lần khởi động thất bại trước đó. Xóa trạng thái failed mà chưa sửa đường dẫn sẽ chỉ lặp lại tình huống.
Giả sử service chạy bằng labapp nhưng thư mục làm việc không cho user này đi qua. Log có thể nhắc tới thay đổi working directory hoặc permission denied. Kiểm tra unit khai báo user nào và dùng namei -l trên đường dẫn đó.
Nếu quyền Unix đã đúng, xem sandbox trong unit, AppArmor hoặc filesystem read-only. Không tăng quyền toàn cây thư mục chỉ vì có chữ “permission” trong log. Mỗi lớp chặn cần được kiểm tra theo cơ chế của nó, và thay đổi phải có phạm vi nhỏ nhất đủ giải quyết yêu cầu.
Sau sửa, kiểm tra bằng chính user dịch vụ. Chạy ứng dụng thử bằng root có thể khiến bạn tưởng đã khôi phục trong khi service thực tế vẫn lỗi. Đầu ra HTTP, file được tạo hoặc thao tác nghiệp vụ mong đợi mới là tiêu chí hoàn thành cùng với trạng thái unit.
Quyền đọc journal phụ thuộc user, group và policy. Thử bằng sudo nếu bạn được cấp quyền quản trị phù hợp. Không cấp group đọc log cho mọi người chỉ để thuận tiện, vì log có thể chứa đường dẫn nội bộ, thông tin tài khoản và dữ liệu ứng dụng.
Kiểm tra nơi lưu journal và cấu hình journald. Lưu bền vững qua reboot cần chính sách phù hợp; đừng tự tạo cơ chế lưu mới trên production mà bỏ qua dung lượng và retention. Khi cần thay đổi, tính lượng log, yêu cầu điều tra và giới hạn lưu trữ trước.
journalctl --disk-usage giúp xem dung lượng journal đang dùng. Các lệnh vacuum có thể xóa lịch sử cũ và ảnh hưởng khả năng điều tra. Trước khi dọn, xác nhận retention, lưu bằng chứng cần thiết và hiểu rằng dữ liệu đã xóa không được journalctl tự phục hồi.
sudo journalctl -u lab-web.service --since '-15 minutes' --no-pager > lab-web-journal.txt
File đầu ra nằm trên tài khoản chạy shell chuyển hướng, không tự có quyền bảo vệ chỉ vì journalctl dùng sudo. Đặt quyền lưu phù hợp, kiểm tra nội dung và che token, thông tin cá nhân trước khi chuyển cho người khác. Không dán toàn bộ log lên diễn đàn công khai.
Biên bản ngắn nên có OS, phiên bản ứng dụng, unit, khoảng thời gian và timezone, triệu chứng, thay đổi gần nhất, dòng lỗi gốc cùng kết quả sau sửa. Nếu không có log cần thiết, ghi rõ khoảng trống bằng chứng thay vì suy luận rằng hệ thống bình thường.
Hoàn thành khi bạn truy ngược được một thất bại từ thao tác tái hiện tới dòng log phù hợp, sửa nguyên nhân và chứng minh chức năng phục hồi. Công cụ lọc tốt giúp giảm thời gian tìm kiếm, nhưng kết luận cuối cùng vẫn cần liên hệ với hành vi ứng dụng và bối cảnh vận hành.
Một dòng log chỉ ghi rằng kết nối thất bại không tự chỉ ra firewall, DNS hay backend là nguyên nhân. Ghép nó với phép thử kết nối, cấu hình đang hiệu lực và thời điểm thay đổi. Nếu chỉ quan sát được hệ quả, ghi kết luận là giả thuyết cần kiểm chứng thay vì khẳng định đã tìm ra lỗi gốc.
Giữ cả một vài dòng trước và sau lỗi khi lập ticket, vì thông báo quan trọng có thể nằm ngay trước lần service dừng. Với nhiều lần restart, phân tách từng lần bằng timestamp hoặc boot ID để không ghép nguyên nhân của lần cũ vào kết quả của lần mới. Ghi rõ thao tác nào là do người quản trị thực hiện trong lúc điều tra để người đọc sau không nhầm đó là lỗi tự phát.
Tạo SSH key từ Windows, Linux hoặc macOS, xác minh host key và kiểm tra phiên đăng nhập mới trước khi hạn chế đăng nhập mật khẩu trên Ubuntu Server.
Tạo tài khoản quản trị, user dịch vụ và thư mục dùng chung trên Ubuntu; chẩn đoán Permission denied theo user, đường dẫn, mode và chính sách truy cập.
Hiểu repository, cài và cập nhật gói trên Ubuntu Server, kiểm tra sau thay đổi và xử lý lỗi lock, DNS hoặc chữ ký mà không bỏ qua cơ chế xác minh.
Thực hành tạo systemd service trên Ubuntu, kiểm tra trạng thái, restart, reload và tự khởi động; tìm lỗi từ user, đường dẫn, quyền và log của dịch vụ.