PHP EP 9: Xử lý chuỗi UTF-8 bằng mbstring trong PHP
Hiểu bản chất mảng byte của chuỗi PHP, thực hành xử lý tiếng Việt UTF-8 bằng mbstring, định dạng chuỗi chuẩn với sprintf và tránh lỗi cắt vỡ ký tự đa byte.
Cắt theo byte có thể làm hỏng tiếng Việt
Khi xây dựng tính năng tạo đoạn trích dẫn (excerpt), chuẩn hóa tiêu đề hoặc giới hạn độ dài tên hiển thị, lập trình viên thường dùng ngay strlen(), substr() hoặc ucfirst() theo thói quen từ tài liệu tiếng Anh. Với văn bản ASCII thuần túy, mỗi ký tự chiếm đúng 1 byte nên vị trí byte trùng khít với vị trí ký tự. Tuy nhiên, trong tiếng Việt chuẩn UTF-8, các nguyên âm có dấu như ă, ệ, đ, ử được mã hóa bằng chuỗi từ 2 đến 3 byte liên tiếp. Nếu cắt chuỗi bằng substr($text, 0, 10) ngay giữa một ký tự 3 byte, byte mồ côi còn sót lại sẽ biến thành ký tự lỗi `` (U+FFFD) hoặc làm json_encode() thất bại với mã JSON_ERROR_UTF8.
Hồ sơ kiểm chứng & Môi trường Lab (Verification Profile):
Ngày kiểm chứng: 2026-10-26.
Môi trường thực thi: Container cô lập php-course-qa:8.4 (--network none, --read-only, --tmpfs /tmp:rw,exec,nosuid,size=64m, user phplab UID 1001).
Phiên bản runtime: PHP 8.4.27 (cli) trên Alpine Linux 3.21 (aarch64), Zend Engine v4.4.27, phần mở rộng mbstring biên dịch sẵn.
Giới hạn kiểm chứng: Kiểm chứng xử lý chuỗi UTF-8 ở mức mã điểm Unicode (code point) với mbstring; không tuyên bố kiểm chứng cụm ký tự ghép (grapheme_* thuộc ext-intl) hay chuẩn hóa NFC/NFD (Normalizer).
Phân biệt hàm chuỗi theo byte và đa byte
Để chọn đúng công cụ cho từng tác vụ mà không lạm dụng mb_* ở nơi chỉ cần xử lý nhị phân, bảng dưới đây tổng hợp hợp đồng kỹ thuật của các nhóm hàm chuỗi trên PHP 8.4:
Tác vụ xử lý
Hàm theo Byte (Chuẩn nhân)
Hàm theo Ký tự UTF-8 (mbstring)
Hành vi thực tế trong PHP 8.4
Điều kiện / Không nên giả định
Đếm độ dài
strlen($s)
mb_strlen($s, 'UTF-8')
strlen('Kỹ sư đạt') trả về 15 byte; mb_strlen() trả về đúng 9 ký tự.
Không dùng mb_strlen() để tính kích thước header Content-Length HTTP hoặc cột byte nhị phân.
Cắt chuỗi con
substr($s, $start, $len)
mb_substr($s, $start, $len, 'UTF-8')
substr() cắt theo vị trí byte; mb_substr() nhảy qua từng code point UTF-8 an toàn.
Cắt theo code point vẫn có thể tách dấu rời nếu dữ liệu nguồn ở dạng tổ hợp NFD chưa chuẩn hóa NFC.
Viết hoa ký tự đầu
ucfirst($s)
mb_ucfirst($s, 'UTF-8') (PHP 8.4)
ucfirst('đạt') giữ nguyên đạt vì đ ngoài ASCII; mb_ucfirst('đạt') đổi thành Đạt.
Cần đảm bảo tiện ích mở rộng mbstring đã kích hoạt trên môi trường chạy (php -m).
Cắt khoảng trắng
trim($s)
mb_trim($s, null, 'UTF-8') (PHP 8.4)
trim() chỉ xóa 6 ký tự khoảng trắng ASCII; mb_trim() xóa cả khoảng trắng Unicode như U+2003, U+00A0.
Văn bản sao chép từ trình soạn thảo thường chứa \u{00A0} khiến trim() thường bỏ sót.
Kiểm tra chuỗi con
str_contains($haystack, $needle)
Dùng chung cho UTF-8 hợp lệ cùng dạng chuẩn hóa
Trả về bool chính xác khi tìm chuỗi con UTF-8 nhờ đặc tính tự đồng bộ biên byte của UTF-8.
Tránh dùng strpos($s, $sub) != false cũ kỹ vì vị trí đầu 0 sẽ bị ép kiểu thành false.
PHP lưu chuỗi byte, mbstring xử lý theo bảng mã
Trong kiến trúc nội bộ của Zend Engine (PHP Manual: Strings), kiểu string là cấu trúc zend_string gồm độ dài byte (len) và mảng các byte liên tiếp. Nhân PHP không gắn nhãn bảng mã vào từng biến chuỗi mà coi mỗi phần tử char là một giá trị 8-bit (0x00 đến 0xFF). Vì vậy, các hàm cốt lõi như strlen(), substr(), strtolower() hay ucfirst() luôn giả định 1 byte = 1 ký tự ASCII.
Khi lưu tiếng Việt UTF-8, chữ đ (U+0111) chiếm 2 byte (0xC4 0x91), còn chữ ỹ hay ệ chiếm 3 byte. Nhờ thiết kế tự đồng bộ của chuẩn UTF-8 (byte nối tiếp luôn bắt đầu bằng bit 10xxxxxx, không bao giờ trùng với byte ASCII 0xxxxxxx hay byte mở đầu 11xxxxxx), các hàm tìm khớp nguyên chuỗi như str_contains(), str_starts_with() và str_ends_with() vẫn chạy chính xác ở mức byte.
Ngược lại, mọi thao tác dựa trên vị trí ký tự hoặc chuyển đổi chữ hoa/thường và khoảng trắng Unicode đều phải dùng mbstring. Từ PHP 8.4, hai RFC mb_ucfirst và mb_trim đã bổ sung trực tiếp mb_ucfirst(), mb_lcfirst(), mb_trim(), mb_ltrim() và mb_rtrim(), chấm dứt việc phải tự ghép mb_strtoupper(mb_substr(...)) thủ công.
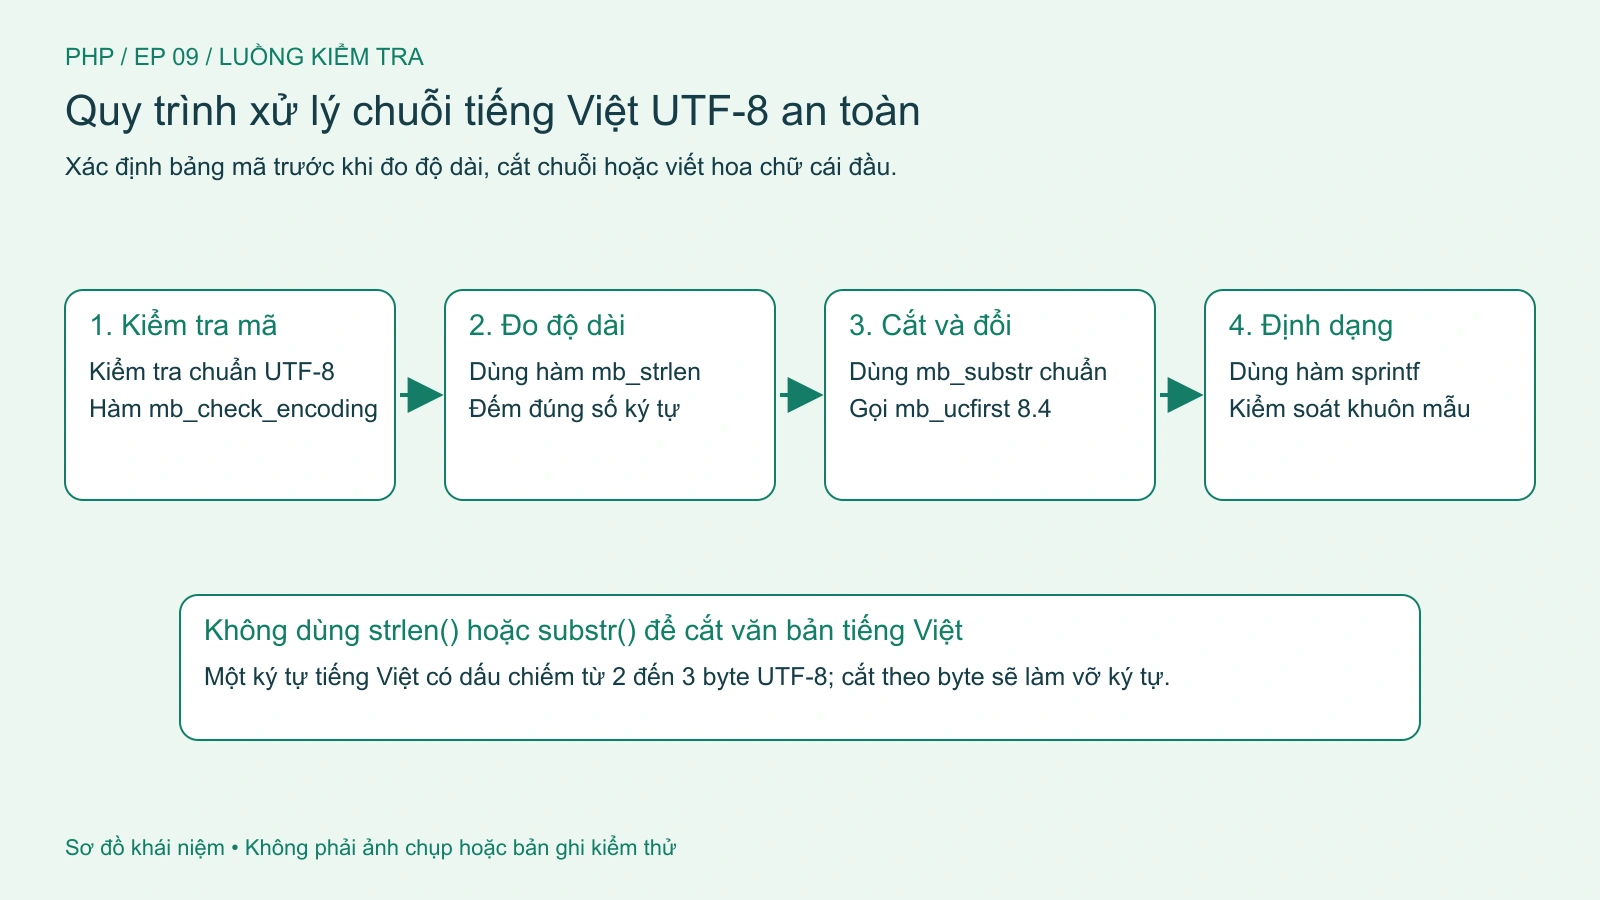
Hình 1. Quy trình kiểm tra bảng mã, độ dài ký tự và thao tác cắt chuỗi tiếng Việt an toàn. Sơ đồ minh họa khái niệm; không phải ảnh chụp hay bản ghi kiểm thử. Mở hình để xem chi tiết.
Kiểm tra chuỗi tiếng Việt trong PHP 8.4
Chúng ta sẽ tạo kịch bản kiểm tra sự khác biệt giữa độ dài byte và độ dài ký tự tiếng Việt, kết hợp mb_trim(), mb_substr(), mb_ucfirst() của PHP 8.4 và str_contains().
Bước 1: Tạo vùng làm việc tạm trong container cô lập
Mục đích: Khởi tạo thư mục thực hành sạch trong /tmp.
WORKDIR="$(mktemp -d /tmp/php-ep09-XXXXXX)"
cd "$WORKDIR"
pwd
Bước 2: Tạo kịch bản utf8_inspect.php xử lý chuỗi tiếng Việt với các hàm PHP 8.4
Mục đích: Đặt chuỗi tiếng Việt chứa khoảng trắng Unicode U+2003 (Em Space) ở hai đầu, làm sạch bằng mb_trim(), đo số byte so với số ký tự, cắt từ cuối bằng mb_substr() và viết hoa chữ đ đầu từ bằng mb_ucfirst().
Đầu ra hiển thị: Bytes=15 | Chars=10 | Slice=đạt | Ucfirst=Đạt | Contains=yes.
Chuỗi Kỹ sư đạt sau khi mb_trim() loại bỏ ký tự U+2003 ở hai đầu còn đúng 10 ký tự Unicode nhưng chiếm 15 byte trong bộ nhớ.
Hàm mb_substr($clean, 6, 3, 'UTF-8') đếm đúng 6 ký tự đầu để trích xuất trọn vẹn chữ đạt, sau đó mb_ucfirst() đổi chữ đ thường thành Đ hoa (Đạt).
Cảnh báo an toàn: Không nối biến trực tiếp vào biểu thức chính quy preg_match("/$userInput/u", $text) mà không qua preg_quote($userInput, '/'), tránh làm vỡ mẫu PCRE hoặc gây treo CPU (ReDoS).
Chuẩn hóa chuỗi và định dạng bằng sprintf
Khi tạo đường dẫn thân thiện (slug) hoặc xuất báo cáo có khuôn mẫu cố định, chúng ta kết hợp mb_strtolower(), mb_trim(), preg_replace() với cờ /u và hàm định dạng sprintf().
Bước 3: Tạo kịch bản slugify_vn.php chuẩn hóa tiêu đề tiếng Việt
Mục đích: Chuyển tiêu đề tiếng Việt có dấu sang dạng slug ASCII kebab-case và định dạng mã hồ sơ bằng sprintf().
Đầu ra in ra: DOC-0009:dinh-chuan-chuoi-utf-8-php-8-4.
Cờ /u (PCRE_UTF8) bắt buộc bộ máy PCRE phân tích mẫu và chuỗi đầu vào theo từng điểm mã UTF-8. Nếu thiếu cờ /u, lớp ký tự [àá...] sẽ bị hiểu thành từng byte rời rạc và làm hỏng chuỗi.
Cảnh báo an toàn: preg_replace() có cờ /u sẽ trả về null nếu chuỗi đầu vào chứa byte UTF-8 bị hỏng. Hãy luôn kiểm tra mb_check_encoding($input, 'UTF-8') ở biên nhận dữ liệu.
Phát hiện UTF-8 bị cắt hỏng và dọn dẹp
Khi cắt chuỗi đa byte bằng substr() theo byte truyền thống, các byte nằm lưng chừng ký tự Unicode sẽ tạo ra chuỗi UTF-8 không hợp lệ.
Bước 4: Cắt chuỗi tiếng Việt bằng substr() và kiểm tra với mb_check_encoding()
Mục đích: Chứng minh substr('Đạt', 0, 1) chỉ lấy byte đầu 0xC4 của chữ Đ (0xC4 0x90), tạo ra chuỗi hỏng và bị mb_check_encoding() chặn lại.
Màn hình in ra ValidUTF8=false. Nếu truyền $broken vào json_encode($broken, JSON_THROW_ON_ERROR), PHP sẽ ném ngay JsonException: Malformed UTF-8 characters.
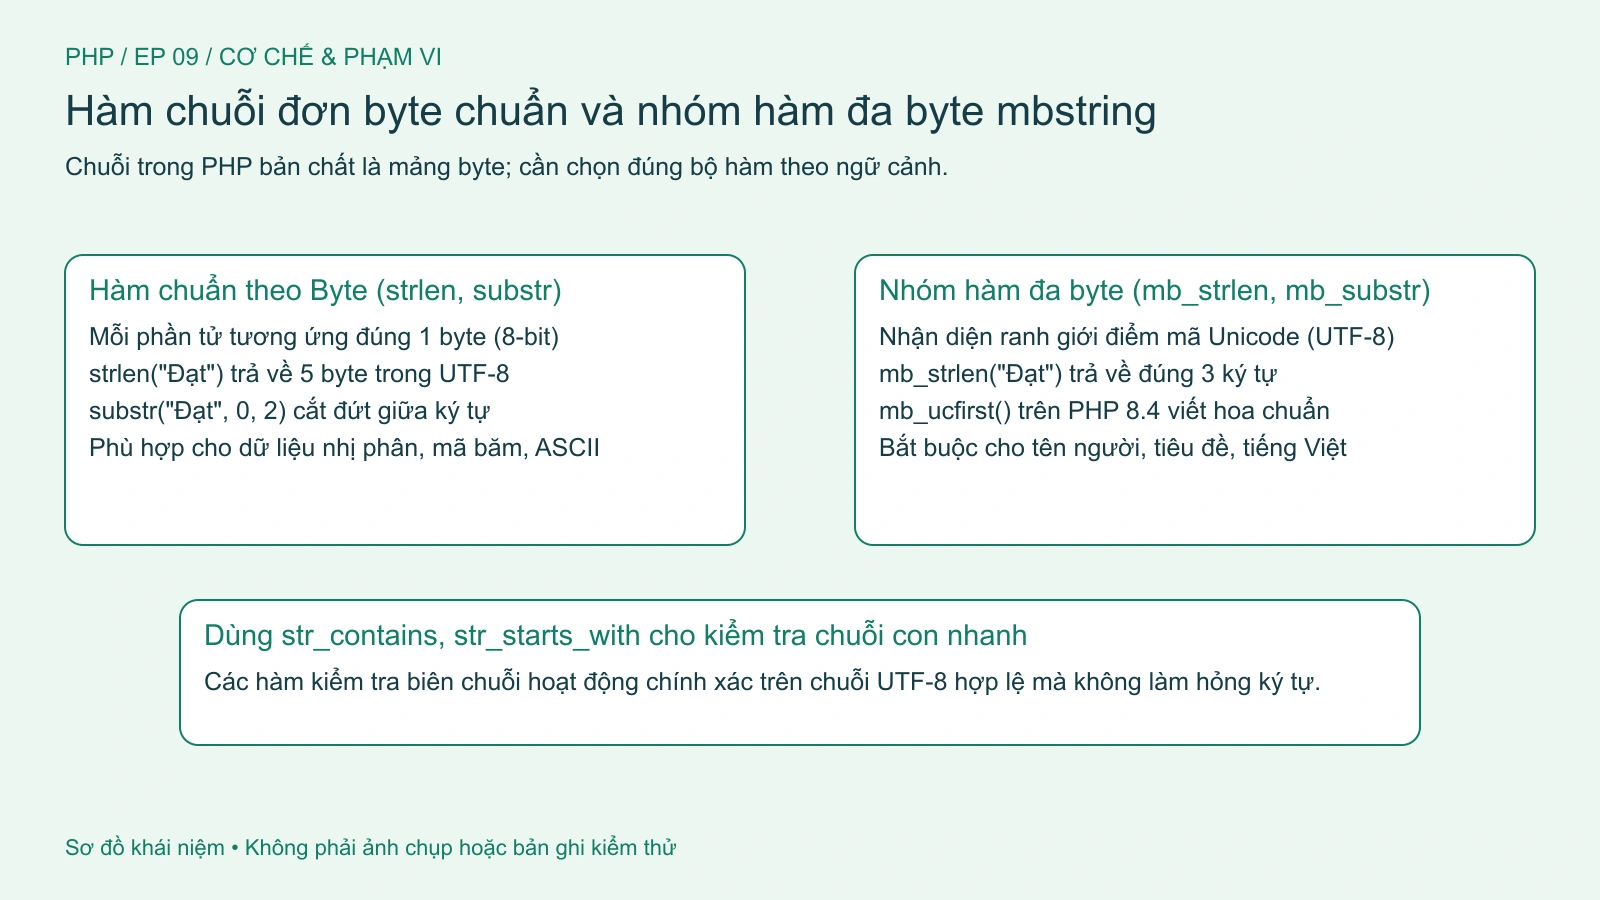
Hình 2. Khác biệt giữa hàm chuỗi theo byte (strlen, substr) và hàm đa byte (mb_strlen). Sơ đồ minh họa khái niệm; không phải ảnh chụp hay bản ghi kiểm thử. Mở hình để xem chi tiết.
Bước 5: Dọn dẹp vùng làm việc tạm
Mục đích: Xóa thư mục thử nghiệm trong /tmp.
rm -rf "$WORKDIR"
Phân biệt chuẩn hóa Unicode và grapheme
Trên môi trường thực tế nhận dữ liệu từ nhiều thiết bị (như bộ gõ tạo chuỗi Unicode tổ hợp rời NFD, nơi chữ ạ gồm chữ a ghép với dấu nặng U+0323), ngay cả mb_strlen() cũng đếm chữ ạ thành 2 mã điểm riêng. Khi triển khai Production:
Chuẩn hóa về dạng dựng sẵn NFC (Normalizer::FORM_C): Bật ext-intl và gọi \Normalizer::normalize($input, \Normalizer::FORM_C) ngay ở tầng tiếp nhận request để gộp dấu rời về ký tự dựng sẵn thống nhất trước khi lưu DB.
Cắt chuỗi theo cụm ký tự hiển thị (grapheme_*): Khi văn bản chứa nhiều biểu tượng cảm xúc ghép (emoji ZWJ), hãy dùng grapheme_strlen() và grapheme_substr() của ext-intl để không cắt đôi biểu tượng.
Tự kiểm tra và giới hạn
Hãy tự đối chiếu 4 câu hỏi tình huống dưới đây:
Câu hỏi 1: Có nên thay thế toàn bộ lệnh strlen() trong dự án bằng mb_strlen() không? -> Không. Khi tính chữ ký HMAC, đo kích thước gói tin hoặc đặt header HTTP Content-Length, bạn bắt buộc phải tính số byte thực tế bằng strlen(). Chỉ dùng mb_strlen() khi đếm số ký tự văn bản hiển thị.
Câu hỏi 2: Các hàm str_contains(), str_starts_with() và str_ends_with() dùng cho chuỗi tiếng Việt UTF-8 có bị sai không? -> Không sai nếu hai chuỗi cùng chuẩn hóa Unicode. Nhờ cấu trúc tự đồng bộ của UTF-8, chuỗi con UTF-8 hợp lệ chỉ khớp byte tại đúng biên ký tự hợp lệ.
Câu hỏi 3: Vì sao gọi ucfirst('đồng nai') vẫn trả về 'đồng nai' viết thường? -> Do dùng hàm đơn byte.ucfirst() chỉ đổi các chữ cái ASCII (a-z). Chữ đ nằm ngoài ASCII nên trên PHP 8.4 phải dùng mb_ucfirst('đồng nai', 'UTF-8').
Câu hỏi 4: Khi dùng preg_match() hoặc preg_replace() xử lý tiếng Việt, cờ hiệu nào là bắt buộc? -> Cờ /u (PCRE_UTF8). Thiếu cờ /u, PCRE sẽ so khớp theo từng byte riêng lẻ và làm hỏng chuỗi UTF-8.
Quản lý giao dịch cơ sở dữ liệu bằng beginTransaction, commit và rollBack trong PHP PDO, thực hành bật ràng buộc khóa ngoại và đóng gói truy vấn vào Repository.
Thiết kế cấu trúc thư mục dự án PHP tách biệt nghiệp vụ và giao diện, thực hành viết kịch bản kiểm thử tự động xác minh nhánh lỗi và đọc Stack Trace để gỡ lỗi.
Tổng hợp kiến thức toàn khóa qua dự án ứng dụng quản lý Ticket bằng PHP và PDO: kết hợp Property Hooks, Enum, Transaction, bảo mật biểu mẫu HTTP và bộ kiểm thử.
Phân tích vòng đời HTTP Request/Response trong PHP qua $_GET, $_POST, $_SERVER, thực hành kiểm tra dữ liệu bằng filter_var và mã hóa đầu ra chống tấn công XSS.