Linux
10 phút•28/10/2026
Kết nối SSH bằng key và cấu hình truy cập an toàn
Tạo SSH key từ Windows, Linux hoặc macOS, xác minh host key và kiểm tra phiên đăng nhập mới trước khi hạn chế đăng nhập mật khẩu trên Ubuntu Server.
GuideĐọc ngay
Phân biệt hết dung lượng với hết inode, dùng df, du và lsof để tìm nguyên nhân; xử lý file đã xóa còn mở và xác nhận dịch vụ sau khi giải phóng dữ liệu.
Lỗi No space left on device có thể xuất hiện dù bạn vẫn thấy dung lượng trống ở một nơi khác. Ứng dụng ghi vào filesystem cụ thể, filesystem có thể hết inode thay vì hết byte, hoặc dữ liệu đã xóa vẫn được tiến trình giữ mở. Bài này dùng Ubuntu Server 24.04 LTS để tìm đúng nguyên nhân trước khi dọn dữ liệu.
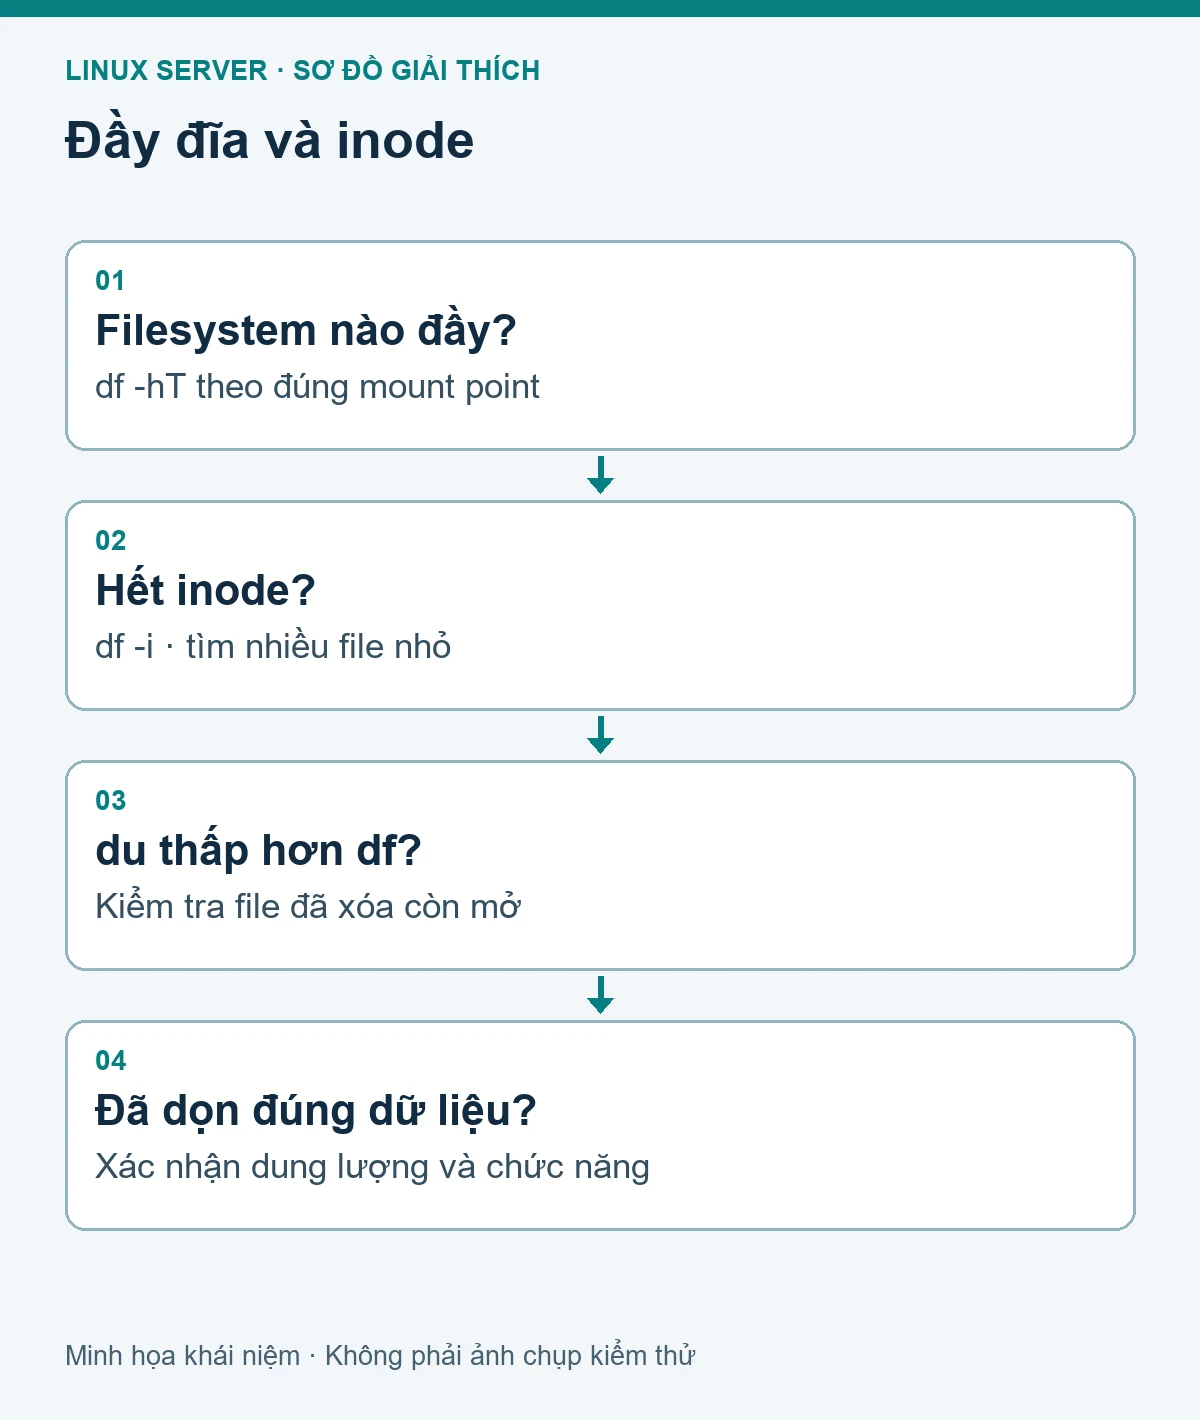
Ghi lại thông báo lỗi, đường dẫn và thời điểm. Phân biệt file log, thư mục tạm, dữ liệu database, upload và thư mục của container. Dung lượng trống trên /home không giúp một /var nằm trên filesystem riêng đã đầy.
df -hT
df -i
lsblk -f
findmnt -T /var/log
df -hT hiển thị dung lượng theo filesystem đã mount. df -i xem inode trên filesystem có thống kê phù hợp. lsblk -f giúp liên hệ thiết bị với filesystem; nó không tự nói ứng dụng có được phép ghi hay quota còn bao nhiêu.
Nếu filesystem bị read-only hoặc user bị quota, thông báo có thể khác trường hợp hết block. Đọc lỗi chính xác thay vì gộp mọi lỗi ghi file vào “đầy ổ”. Không remount read-write một filesystem gặp lỗi mà chưa xem kernel log và nguyên nhân bảo vệ.
Ví dụ khi /var là nơi cần điều tra:
sudo du -xhd1 /var 2>/dev/null | sort -h
sudo du -xhd1 /var/log 2>/dev/null | sort -h
-x giới hạn trong một filesystem, giúp tránh vô tình đi vào mount khác. -d1 cho một mức thư mục để khoanh vùng; sau đó thu hẹp vào nhánh lớn thay vì quét sâu toàn máy ngay từ đầu. Trên volume rất lớn, du có thể tạo I/O đáng kể, nên cân nhắc thời điểm và tần suất.
Chuyển stderr sang /dev/null làm kết quả gọn nhưng có thể che lỗi đọc; nếu thấy số liệu bất thường hoặc thiếu thư mục, chạy lại có giữ lỗi và kiểm tra quyền. Một kết quả du thiếu quyền không phải bản kiểm kê đầy đủ.
Kích thước apparent và block thực tế có thể khác với sparse file, compression hoặc filesystem đặc thù. Đừng chỉ nhìn cột size của ls -l rồi suy ra byte trên đĩa. Công cụ quản trị chính thức của storage hoặc filesystem có thể cần thiết khi mô hình lưu trữ phức tạp.
Một filesystem có thể còn nhiều GB nhưng hết khả năng tạo đối tượng mới do inode cạn. Điều này hay liên quan rất nhiều file nhỏ, nhưng cần kiểm tra thực tế thay vì đoán từ tên thư mục.
df -i /var
sudo du --inodes -x -d1 /var 2>/dev/null | sort -n
Nếu công cụ hoặc filesystem không hỗ trợ thống kê như ví dụ, đối chiếu tài liệu và dùng phương pháp phù hợp. Sau khi khoanh vùng, xác định ứng dụng nào tạo file và chính sách retention của nó. Xóa được triệu file hôm nay mà không sửa tác vụ sinh file có thể khiến sự cố lặp lại ngày mai.
Không thử tái hiện hết inode trên filesystem root của máy đang vận hành. Lab có thể dùng một filesystem riêng có kích thước nhỏ và số inode giới hạn. Chỉ mount ảnh đĩa hoặc thiết bị thử đã xác định rõ, giữ khoảng cách với volume chứa dữ liệu thật.
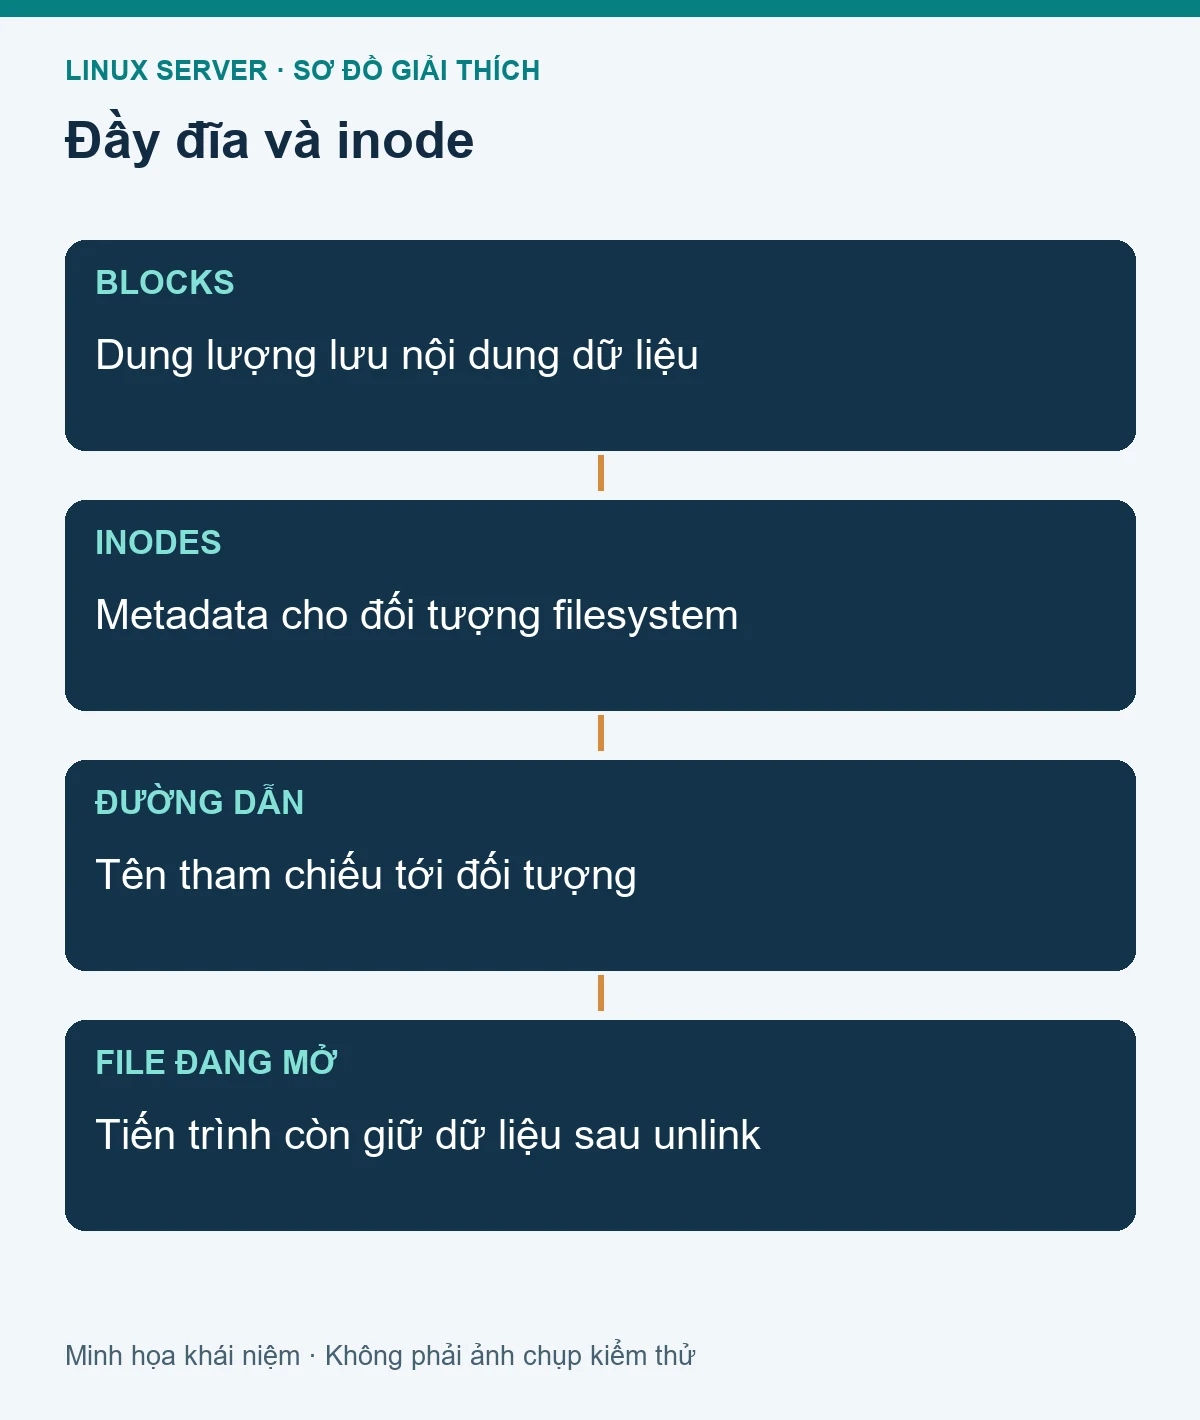
Một nguyên nhân cần kiểm tra là file đã bị unlink nhưng vẫn mở trong tiến trình. Tên file không còn trong cây thư mục, song block chưa được giải phóng cho đến khi tham chiếu cuối cùng đóng. Kiểm tra bằng:
sudo lsof +L1
Đọc cột process, PID, kích thước và filesystem để xác định đối tượng liên quan. Không phải mọi dòng deleted đều lớn hoặc cần xử lý. Trước khi restart tiến trình, xem đó là service gì, có cơ chế reopen log không và thao tác có gián đoạn người dùng hay giao dịch đang chạy không.
Với log rotation, ứng dụng có thể cần tín hiệu hoặc cơ chế reopen chính thức. Xóa file log đang mở không bảo đảm lấy lại dung lượng ngay. Không ghi vào /proc/PID/fd/... theo mẹo chung vì có thể làm mất dữ liệu hay ảnh hưởng cách ứng dụng quản lý file.
Các nguyên nhân khác gồm mount che dữ liệu bên dưới, reserved space, snapshot hoặc tính năng riêng của filesystem. Nếu chưa phân biệt được, giữ kết quả kiểm tra và chuyển cho người quản trị storage trước khi unmount hay thay đổi phân vùng.
Journal: xem sudo journalctl --disk-usage. Vacuum xóa lịch sử cũ nên cần kiểm tra yêu cầu retention và giữ bằng chứng sự cố trước. Nó không phải bước đầu tiên khi log đang là nguồn điều tra quan trọng.
APT cache: kiểm tra /var/cache/apt/archives. Dọn cache gói tải xuống không gỡ ứng dụng đã cài, nhưng có thể cần tải lại khi dùng. Không nhầm cache với cơ sở dữ liệu dpkg hoặc xóa lock để “giải phóng”.
Ứng dụng: dùng cơ chế retention hoặc công cụ dọn do phần mềm hỗ trợ. Với database, không xóa trực tiếp file dữ liệu hay transaction log từ filesystem. Các file đó có quan hệ nhất quán mà ứng dụng quản lý.
Docker: kiểm kê image, container, log và volume trước. Lệnh prune có thể xóa dữ liệu hoặc tài nguyên cần rollback tùy tùy chọn. Bài này không đề xuất một lệnh prune hàng loạt; đối chiếu nội dung chuyên mục Docker theo đúng loại dữ liệu.
Nếu cần xóa file tạm, xác nhận ứng dụng không còn dùng và hiểu policy. Đừng dùng mẫu rm -rf /tmp/* như công thức vận hành chung. Tên thư mục “tmp” không chứng minh mọi mục trong đó đều có thể xóa vào bất kỳ thời điểm nào.
Tăng dung lượng thiết bị ảo có thể mới là bước đầu. Phân vùng, LVM logical volume và filesystem có thể cần mở rộng tương ứng. Mỗi lớp cần xác định bằng lsblk, findmnt và công cụ của LVM nếu có.
Không chạy resize2fs trên XFS hoặc mặc định một lệnh mở rộng phù hợp mọi kiểu cài. Trước thay đổi cấu trúc lưu trữ, có backup đã kiểm tra và hướng dẫn theo filesystem đang dùng. Nếu quản lý qua cloud volume, đối chiếu tài liệu của nhà cung cấp và giới hạn của loại disk.
Mở rộng có thể là biện pháp giảm áp lực để phục hồi, nhưng vẫn phải xử lý tăng trưởng bất thường. Một tác vụ tạo log vô hạn sẽ tiếp tục tiêu thụ volume mới. Đặt cảnh báo theo dung lượng, inode và tốc độ tăng thay vì chỉ phản ứng khi ứng dụng đã ghi thất bại.
Tạo một thư mục thử trong volume lab còn trống, ghi một file nhỏ, mở file bằng một tiến trình rồi xóa tên file. Đối chiếu du với lsof, sau đó cho tiến trình đóng file và kiểm tra dung lượng. Bài tập này không cần tạo hàng GB dữ liệu và không được cố ý làm đầy root.
Với bài inode, dùng filesystem ảnh riêng và một số lượng file có giới hạn. Khi hết inode, ghi nhận lỗi tạo file, xóa đúng dữ liệu thử và xác nhận thao tác tạo file thành công trở lại. Giữ script trong lab để biết chính xác phạm vi được tạo; không dùng wildcard nhắm vào thư mục người dùng.
Đối chiếu cách tính dung lượng trong tài liệu GNU df và GNU du, nhất là khi hai công cụ cho số liệu khác nhau.
Sau khi giải phóng dữ liệu, chạy lại df -hT và df -i trên filesystem liên quan. Kiểm tra ứng dụng ghi được file cần thiết, service không ở trạng thái failed và log không lặp lỗi cũ. Một số ứng dụng cần phục hồi riêng sau khi write thất bại; dung lượng trống trở lại chưa tự sửa mọi trạng thái.
Ghi dữ liệu đã xử lý, dung lượng lấy lại, nguyên nhân và chính sách ngăn tái diễn. Nếu chưa biết dữ liệu có được phép xóa, dừng ở bước kiểm kê và hỏi chủ sở hữu dữ liệu. Chuyển cho IT khi có lỗi thiết bị, filesystem read-only bất thường hoặc cần thao tác storage vượt quyền.
Tạo SSH key từ Windows, Linux hoặc macOS, xác minh host key và kiểm tra phiên đăng nhập mới trước khi hạn chế đăng nhập mật khẩu trên Ubuntu Server.
Tạo tài khoản quản trị, user dịch vụ và thư mục dùng chung trên Ubuntu; chẩn đoán Permission denied theo user, đường dẫn, mode và chính sách truy cập.
Hiểu repository, cài và cập nhật gói trên Ubuntu Server, kiểm tra sau thay đổi và xử lý lỗi lock, DNS hoặc chữ ký mà không bỏ qua cơ chế xác minh.
Thực hành tạo systemd service trên Ubuntu, kiểm tra trạng thái, restart, reload và tự khởi động; tìm lỗi từ user, đường dẫn, quyền và log của dịch vụ.