MySQL
8 phút•23/10/2026
Bài 2: MySQL CLI và phân quyền: thao tác rõ, quyền vừa đủ
Dùng MySQL CLI có kiểm chứng: xác nhận server, TLS, account, role và tác động của KILL hoặc SET PERSIST trước khi quản trị.
GuideĐọc ngay
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
Máy chủ có 128 GiB RAM nhưng truy vấn vẫn chậm, hoặc vừa tăng Buffer Pool thì MySQL bị OOM. Hai tình huống này cần hai cách điều tra khác nhau. Cấp thêm bộ nhớ chỉ có ích khi giữ được working set cần thiết và vẫn còn khoảng trống cho các thành phần khác.
Bài này dùng MySQL 8.4, InnoDB trên Linux. Các con số là ví dụ tính ngân sách, không phải cấu hình đã benchmark. Với container hoặc máy dùng chung, lấy giới hạn tài nguyên thực tế thay vì nhìn tổng RAM vật lý của host.
Buffer Pool giữ các trang dữ liệu và chỉ mục InnoDB. Nó không phải toàn bộ bộ nhớ của mysqld: kết nối, thao tác sort/join, temporary table, Performance Schema và các cấu trúc nội bộ còn dùng thêm RAM. Một truy vấn đọc ít dữ liệu nhưng chọn kế hoạch tệ vẫn có thể chậm khi cache hit cao.
Đừng đồng nhất RAM trống với RAM có thể cấp hết. Hãy ghi peak RSS, swap activity, memory pressure, số phiên thực sự hoạt động và lịch backup cùng một khoảng thời gian tải. Linux page cache có thể thu hồi khác với bộ nhớ anonymous; một ảnh chụp free RAM không mô tả đủ rủi ro OOM.
Với máy 128 GiB, thử lập phương án Buffer Pool 80 GiB, phần mysqld ngoài pool 16 GiB, hệ điều hành và tiến trình phụ 16 GiB, dự phòng 16 GiB. Tổng là 128 GiB; đây là giả định để đo, không bảo đảm tải của bạn chỉ dùng đúng 16 GiB ngoài pool. Tải có nhiều truy vấn đồng thời hoặc backup nén có thể cần ngân sách khác.
Không lấy max_connections nhân mọi buffer cấu hình rồi gọi đó là lượng RAM luôn cấp phát. Nhiều buffer phát sinh theo thao tác và có thể xuất hiện nhiều lần trong một truy vấn. Cần kết hợp giới hạn lý thuyết với số đo workload; giảm concurrency có thể hữu ích hơn việc đẩy pool lên 80% bất kể bối cảnh.
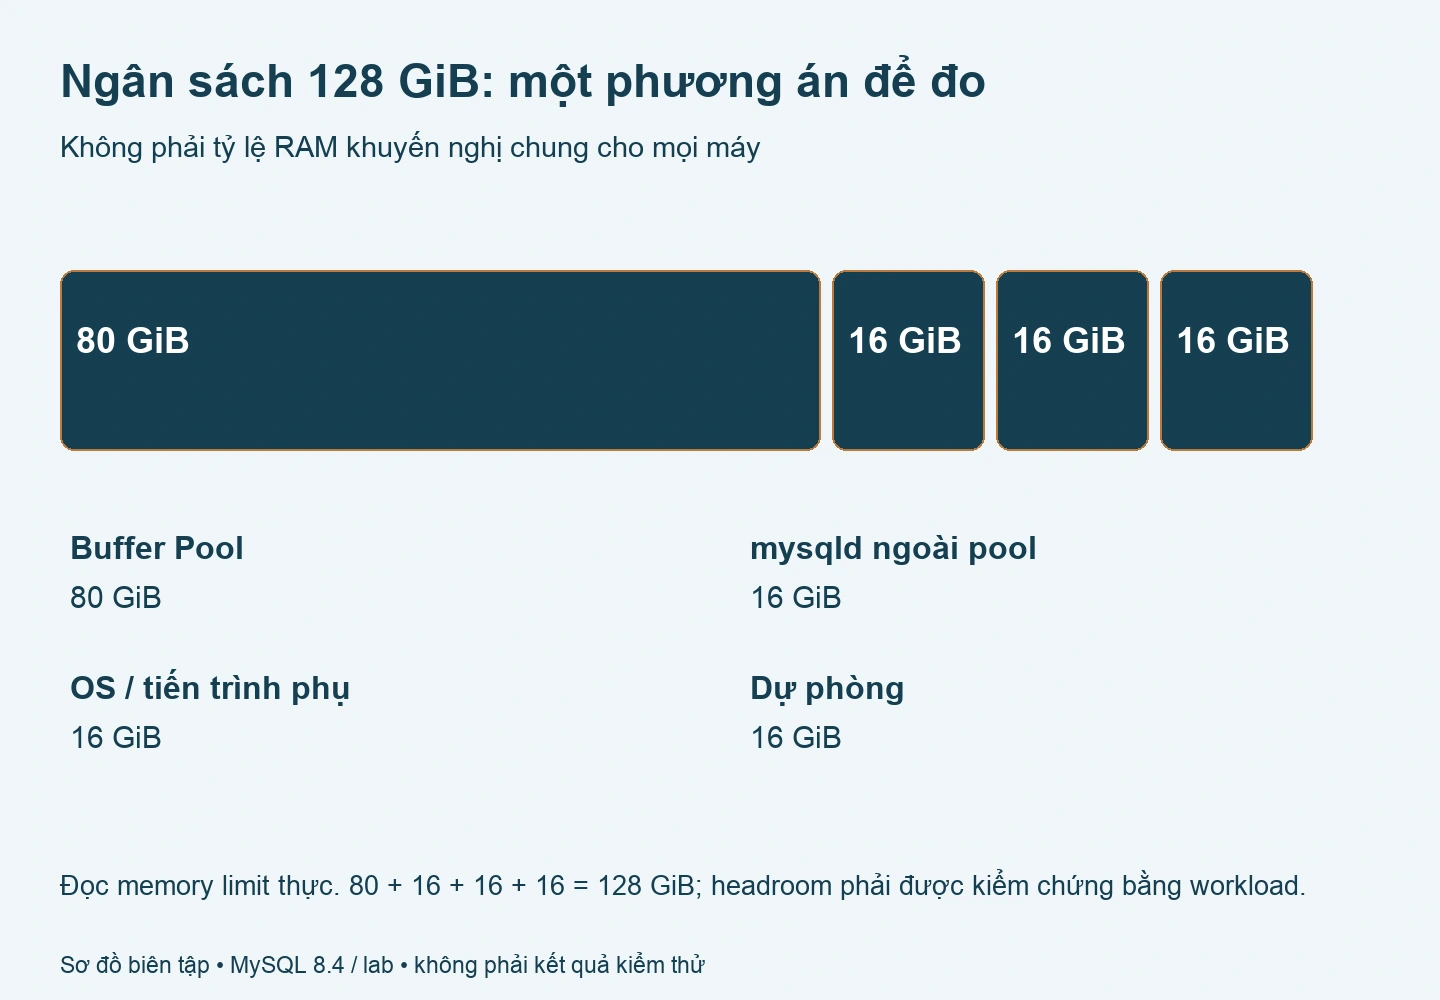
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Trong MySQL 8.4, pool được chia thành instance và chunk theo cấu hình. Quy tắc căn chỉnh liên quan đến tích chunk size × số instance. Ví dụ chunk 128 MiB và 16 instance tạo bước 2 GiB, nên 80 GiB là một bội hợp lệ. Giá trị thực có thể được điều chỉnh; đọc lại biến sau khi áp dụng thay vì chỉ nhìn file.
SHOW GLOBAL VARIABLES WHERE Variable_name IN
 ('innodb_buffer_pool_size','innodb_buffer_pool_instances',
  'innodb_buffer_pool_chunk_size');
SHOW GLOBAL STATUS LIKE 'Innodb_buffer_pool_resize_status';
Không tăng số instance để “triệt tiêu mutex” theo số CPU một cách máy móc. Kích thước mỗi instance và chi phí quản lý cần phù hợp bản đang chạy. Thay đổi size động vẫn có tác động tới workload; lên kế hoạch, ghi giá trị trước và theo dõi tiến độ resize.
Dump/load của Buffer Pool lưu danh sách nhận diện trang để đọc lại, không phải file backup chứa dữ liệu thay cho tablespace. Thời gian warm-up phụ thuộc I/O, số trang, tải mới và trạng thái dữ liệu. Không hứa một lần bật sẽ hết cold cache.
[mysqld]
innodb_buffer_pool_dump_at_shutdown = ON
innodb_buffer_pool_load_at_startup = ON
innodb_buffer_pool_dump_pct = 25
25 là tỷ lệ trang được chọn cho dump theo cơ chế của bản MySQL, không phải tỷ lệ dữ liệu đã backup. Sau restart, đọc trạng thái load và latency ứng dụng; một load hoàn tất chưa chứng minh working set hiện tại đã đủ.
Máy nhiều socket có thể chịu chi phí truy cập bộ nhớ xa. Chính sách NUMA, THP, allocator và giới hạn cgroup phải được xem cùng kernel, phần cứng và workload. Không có một giá trị swappiness bảo đảm chỉ swap ngay trước OOM; kernel cân bằng các loại bộ nhớ theo cơ chế của nó.
Đọc cấu hình đang chạy, phân bố memory trên NUMA node, swap-in/out và sự kiện OOM trước. Nếu muốn thử interleave hoặc THP policy, dùng môi trường đại diện, thay một biến, ghi thông số cũ và chốt cửa sổ đánh giá. Tránh thêm nhiều dòng sysctl trùng lặp hoặc đổi policy toàn host chỉ vì một bài hướng dẫn.
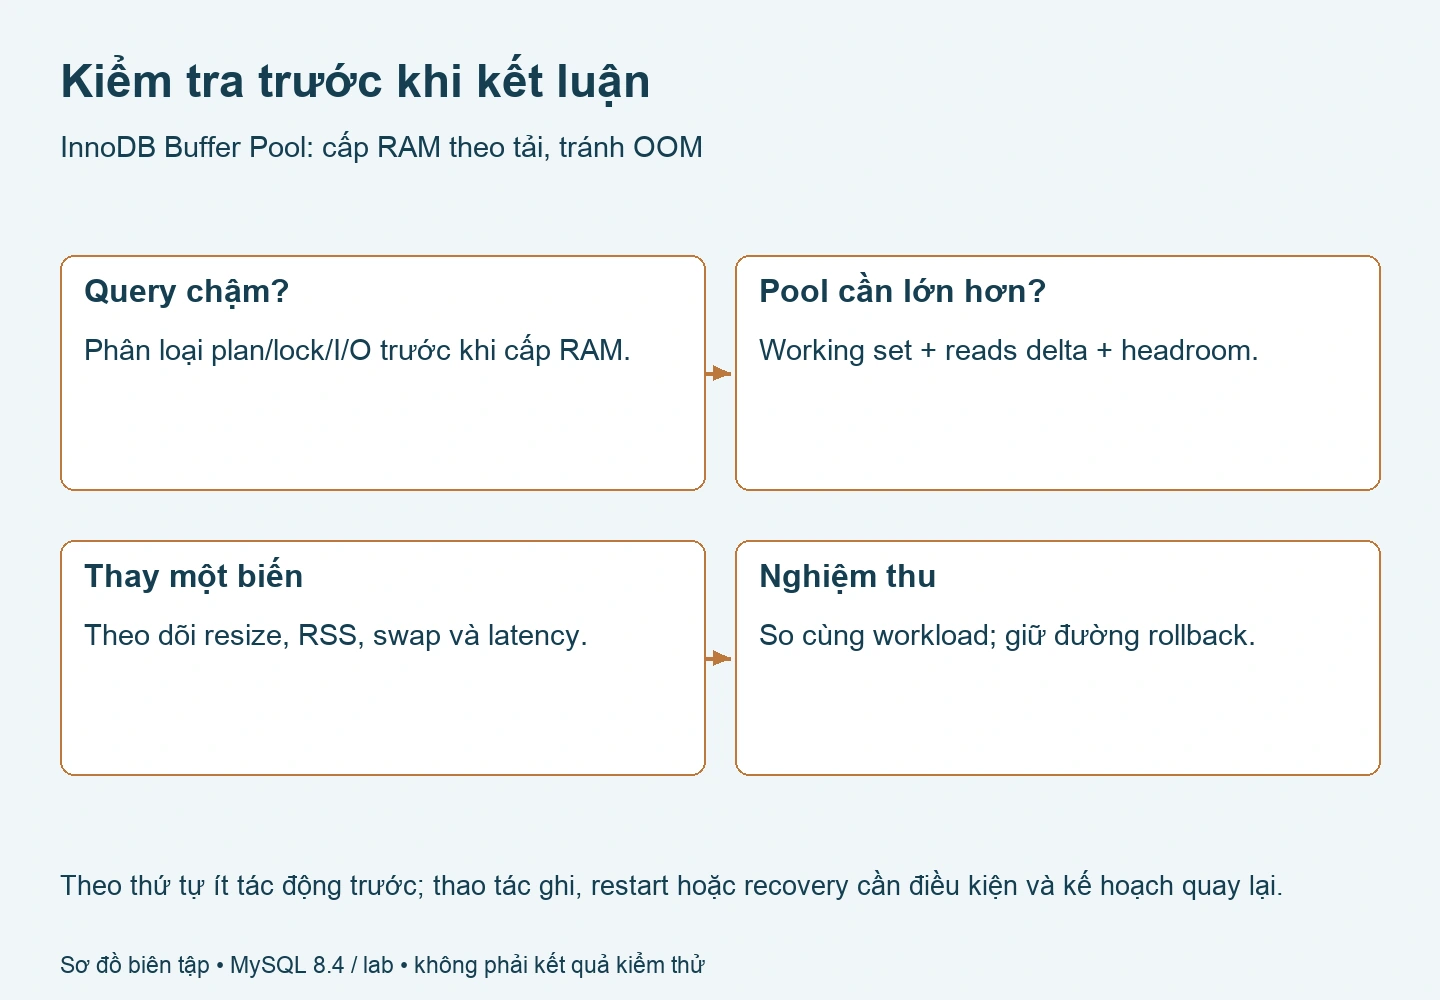
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Lấy delta của Innodb_buffer_pool_reads và Innodb_buffer_pool_read_requests trong cùng cửa sổ không restart. Tỷ lệ đọc logic không cần đọc vật lý có thể ước tính bằng 1 − delta_reads / delta_read_requests khi mẫu số dương. Counter lifetime dễ che đợt workload mới.
SHOW GLOBAL STATUS WHERE Variable_name IN
 ('Innodb_buffer_pool_reads','Innodb_buffer_pool_read_requests',
  'Innodb_buffer_pool_pages_dirty','Innodb_buffer_pool_wait_free');
Ví dụ 1.000 lượt đọc vật lý trên 1.000.000 yêu cầu logic cho tỷ lệ 99,9%. Chỉ số đẹp này vẫn có thể đi cùng query scan lớn, lock wait hoặc storage flush chậm. So thêm latency p95/p99, I/O latency, dirty pages và throughput nghiệp vụ.
Chọn một giá trị từ ngân sách, không từ bảng 64–512 GB áp dụng đại trà. Lưu biến thực, file cấu hình và giá trị persist trước sửa. Nếu tăng pool, đánh giá latency, RSS, swap và lỗi trong tải tương đương; nếu giảm, dự kiến tăng đọc đĩa và khả năng tác động giao dịch đang chạy.
Checklist: đúng version và memory limit; có baseline; size căn chỉnh; đủ headroom; không thêm I/O capacity hay thread count tùy ý; biết cách quay lại; xác nhận qua ứng dụng. Đọc tiếp bài hiệu năng để kiểm tra query trước khi quy mọi vấn đề về bộ nhớ.
Tình huống giả định để luyện phân tích, không phải kết quả đo.
Giả sử một máy 128 GiB được tăng pool từ 80 lên 100 GiB, còn lịch backup nén vẫn chạy cùng cao điểm. RSS tăng, memory pressure xuất hiện và latency xấu hơn, dù hit ratio không giảm. Dữ kiện đó hỗ trợ giả thuyết thiếu headroom, nhưng chưa chứng minh backup là nguyên nhân duy nhất. Ghi concurrency, thời điểm job và storage latency để so tải tương đương.
Bước ít tác động là giữ baseline và đọc bộ nhớ theo process/cgroup, rồi phân biệt swap activity với page cache bị thu hồi. Nếu lỗi chỉ xảy ra trong một câu truy vấn, mở nhánh plan/lock thay vì tiếp tục tăng pool. Nếu mọi query đều chịu ảnh hưởng khi job chạy, kiểm tra CPU/I/O của job và ngân sách RAM ngoài pool.
Phương án thử có thể quay về 80 GiB trong cửa sổ được phép, đồng thời giữ workload và lịch job như cũ để có đối chứng. Không đổi THP, NUMA và workers cùng lúc. Nếu latency cải thiện, kết luận phù hợp là phương án bộ nhớ mới tốt hơn trong mẫu tải đã đo; nó không chứng minh 80 GiB là mức tối ưu cho mọi ngày hoặc mọi dữ liệu.
Khi dữ liệu tăng, ngân sách cần được xem lại. Một bảng báo cáo scan toàn lịch sử có thể đẩy trang nóng ra khỏi cache, còn index mới có thể giảm working set truy cập. Lưu cả query digest và kế hoạch thay đổi schema bên cạnh đồ thị RAM để không tối ưu từng lớp tách rời.
Phạm vi tham chiếu là tài liệu theo phiên bản ghi trong bài. Khi áp dụng, đối chiếu model triển khai, bản patch và quyền đang dùng; các ví dụ chưa được kiểm thử trên máy chủ thật.
Tiếp tục theo mạch kiến thức:
Dùng MySQL CLI có kiểm chứng: xác nhận server, TLS, account, role và tác động của KILL hoặc SET PERSIST trước khi quản trị.
Chọn mysqldump, MySQL Shell hoặc physical backup theo RPO/RTO; kiểm tra tính nhất quán, GTID, binlog và nghiệm thu bằng restore riêng.
Cài MySQL 8.4 LTS hoặc MariaDB 11.4 trên máy mới: kiểm tra repository, package, service, tài khoản và phiên bản server trước nghiệm thu.
Phân biệt Group Replication, Shell và Router; so sánh InnoDB Cluster với Galera qua quorum, đường ghi, recovery và nhu cầu vận hành.