MySQL
8 phút•23/10/2026
Bài 5: InnoDB Buffer Pool: cấp RAM theo tải, tránh OOM
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
#mysqlĐọc ngay
Phân biệt mất quorum với complete outage; xác minh fencing, GTID superset và dữ liệu trước force quorum, reboot hoặc clone lại member.
Một node trả lời SSH còn hai node không truy cập được chưa đủ để kết luận chỉ còn một bản dữ liệu tồn tại. Nếu force quorum từ góc nhìn đó khi một partition khác vẫn đang ghi, thao tác phục hồi có thể tạo ra vấn đề nghiêm trọng hơn sự cố ban đầu.
Phần 8 dùng InnoDB Cluster/MySQL Shell 8.4 và lab ba member. Các thủ tục force, rejoin và reboot cần người vận hành xác minh toàn topology, backup và fencing. Không thực hiện chúng như một script sửa lỗi chung.
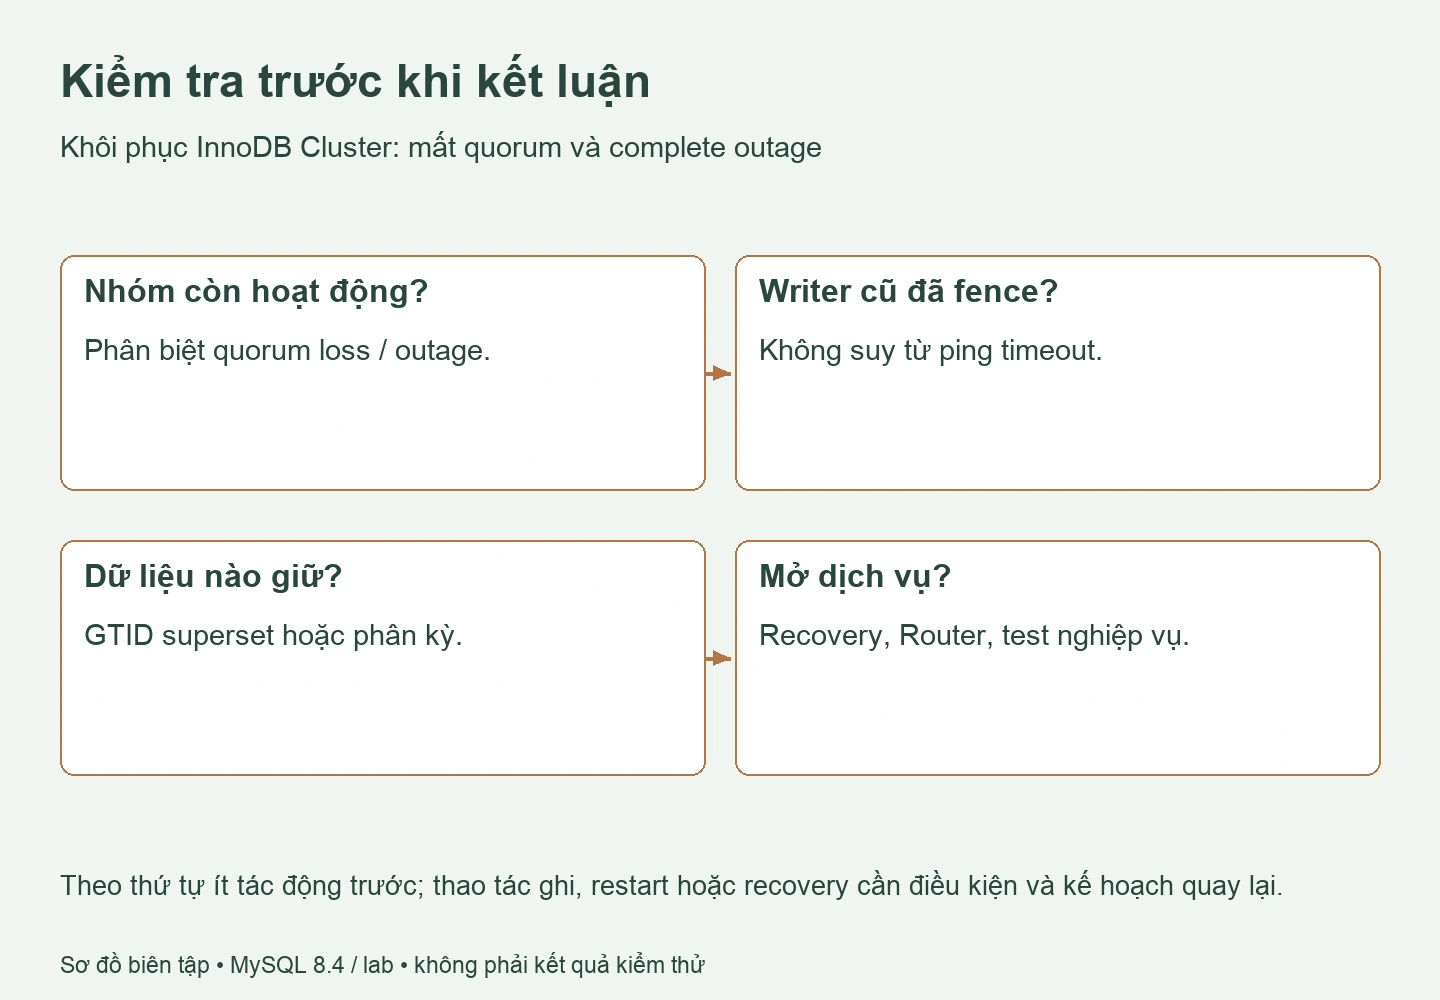
Một member rời nhóm nhưng đa số còn hoạt động khác với nhóm không còn đa số. Complete outage trong runbook Shell là Group Replication đã dừng trên tất cả member, không chỉ là máy quản trị không tới được server. Cần thu thập từ nhiều điểm quan sát.
Giữ timestamp, topology, member state, error log, biến read_only/super_read_only và GTID. Không restart toàn bộ để thử trước khi lưu bằng chứng. Chặn ghi ứng dụng hoặc cô lập topology theo kế hoạch ứng cứu để tránh phát sinh dữ liệu ngoài kiểm soát.
Nhóm ba member cần đa số hai theo view phù hợp. Nếu mất liên lạc, thử khôi phục mạng hoặc member hợp lệ trước. Đếm process mysqld sống không thay đánh giá group membership. Một status đọc từ partition đơn lẻ không nhìn được toàn bộ hạ tầng.
Xác minh những member không thấy được đã dừng hoặc được fence theo cơ chế hạ tầng đáng tin; “ping không trả lời” không phải fencing. Giữ bản sao dữ liệu của các phía nếu còn nghi ngờ phân kỳ. Khi chưa xác định writer hợp lệ, dừng thủ tục cưỡng chế và chuyển cấp DBA/hạ tầng.
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Chỉ khi đã loại trừ partition khác còn phục vụ, chọn partition được giữ và đối chiếu dữ liệu, mới dùng forceQuorumUsingPartitionOf. Nó dựa trên góc nhìn thành viên ONLINE của instance được chỉ định, không đơn giản là “cho một node tự làm primary”.
// Chỉ sau khi xác minh và cô lập các partition khác
var cluster = dba.getCluster('labCluster');
cluster.forceQuorumUsingPartitionOf('clusteradmin@mysql-node1:3306');
cluster.status({extended: 1});
Đây là lệnh thay topology có rủi ro split-brain nếu dùng sai. Ghi quyết định, backup/snapshot và người phê duyệt trong runbook riêng. Sau lệnh, kiểm tra group view, role, Router và quyền ghi; không mở lại ứng dụng chỉ vì command không ném exception.
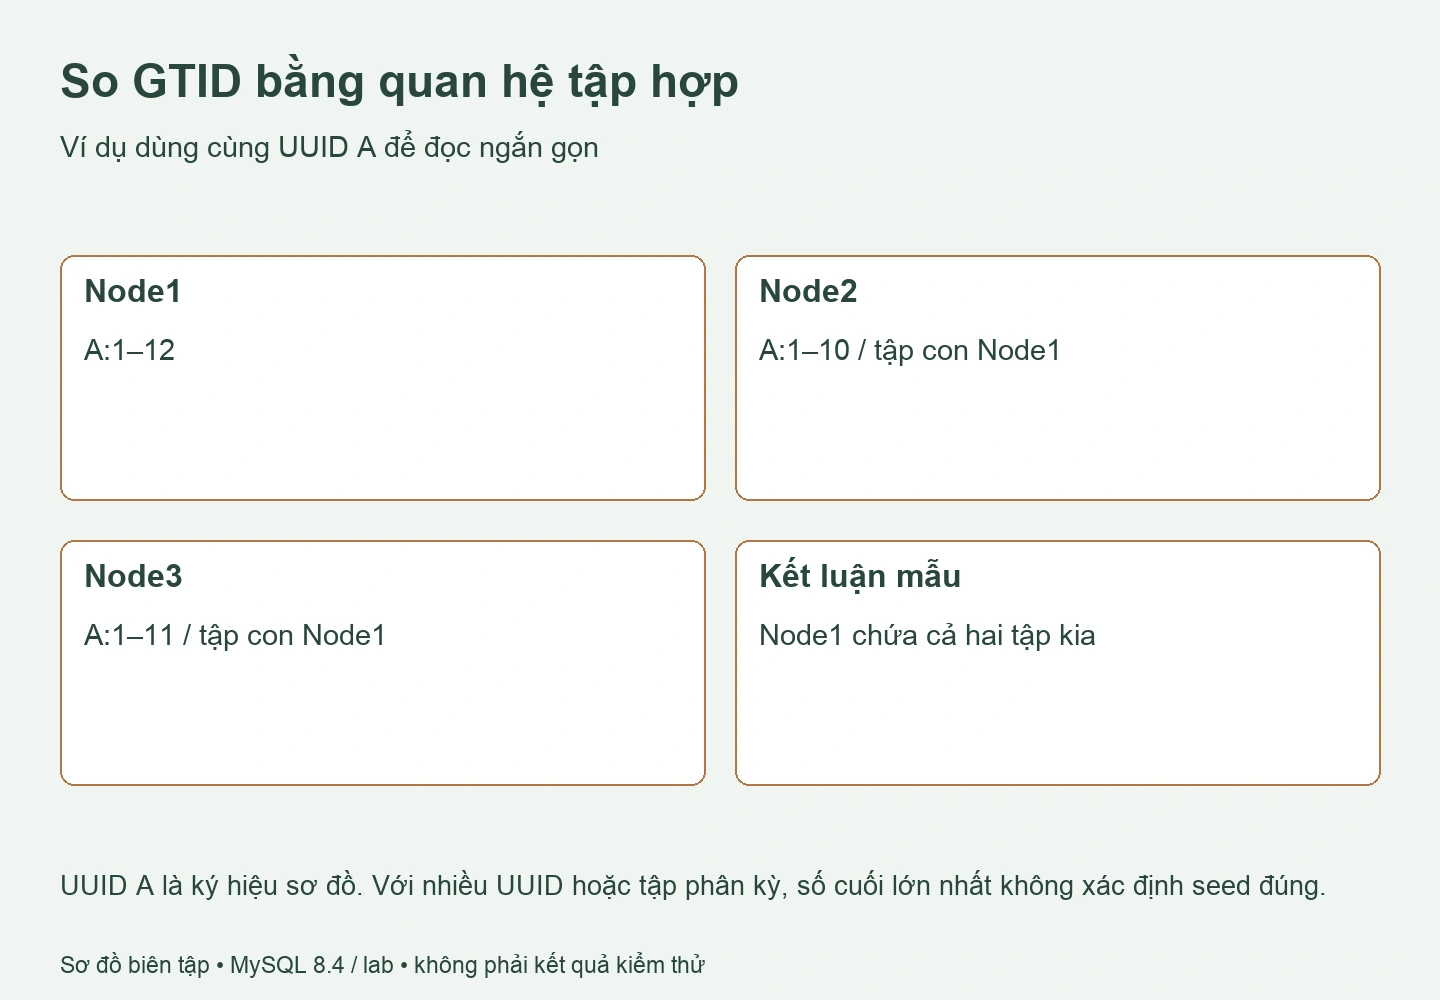
Đưa các member tới trạng thái cho phép kiểm tra, giữ ứng dụng cách ly và thu gtid_executed từ từng nơi. Tập GTID có thể gồm nhiều UUID và nhiều khoảng; số cuối lớn hơn không chứng minh chứa toàn bộ giao dịch của tập khác.
SELECT GTID_SUBSET(
 'aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa:1-10',
 'aaaaaaaa-aaaa-aaaa-aaaa-aaaaaaaaaaaa:1-12'
) AS first_is_subset;
Mẫu minh họa phép so tập, không đọc dữ liệu thật. Nếu các tập phân kỳ, không có cách chọn seed đúng chỉ bằng một con số. Dùng kiểm tra của Shell cùng phân tích dữ liệu; force với tập thấp hơn có thể mất transaction.
dba.rebootClusterFromCompleteOutage('labCluster', {dryRun: true});Chạy dryRun từ candidate theo report và manual 8.4. Chỉ bỏ dryRun để thực hiện sau khi tất cả điều kiện đã được xác nhận. Mặc định yêu cầu kiểm tra member có thể tiếp cận; không dùng force để bỏ qua host chưa kiểm tra chỉ vì muốn hoàn tất nhanh.
ERROR/UNREACHABLE có nhiều nguyên nhân: mạng, authentication, disk, recovery hoặc apply error. Đọc log trước removeInstance(force:true). Xóa khỏi metadata không sửa nguyên nhân và có thể làm mất bối cảnh quản lý.
cluster.rejoinInstance('clusteradmin@mysql-node2:3306');Mẫu dành cho member đã xác định đủ điều kiện rejoin. Nếu phải clone lại, sao lưu dữ liệu receiver cần giữ và chấp nhận nó bị thay thế; kiểm tra donor, compatibility và tài nguyên. Không ghép remove-force + clone thành phương án mặc định cho mọi lỗi.
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
GTID_SUBTRACT(executed, purged) chỉ cho biết phần của executed không nằm trong purged của cùng input, không tự xác định errant transaction. Phải so tập của instance nghi vấn với tập authoritative phù hợp, xét view-change transactions và lịch sử topology.
Đừng bơm empty transaction vào primary để làm hai tập nhìn giống nhau mà chưa hiểu dữ liệu nghiệp vụ. Nó có thể che sai lệch logic; GTID cân bằng không chứng minh các row giống nhau. Giữ backup hai phía, tìm tác động transaction và lập phương án phục hồi có kiểm chứng.
Kiểm tra membership/role, GTID theo mô hình đã chọn, recovery hoàn tất và cảnh báo. Sau đó kiểm tra Router bằng kết nối mới, giao dịch đọc/ghi có khóa nhận diện và tính nhất quán ứng dụng. Đo RPO/RTO thực, ghi phần dữ liệu còn không chắc chắn thay vì tuyên bố “khôi phục toàn vẹn” từ chữ OK.
Checklist kết thúc: fencing được kiểm chứng; dữ liệu cũ giữ theo policy; backup mới; monitoring bình thường; timeline và quyết định được lưu; có kế hoạch điều tra nguyên nhân. Lộ trình MySQL của chuyên mục nối cài đặt, quyền, backup, hiệu năng, replication và tám phần Cluster, nhưng không thay diễn tập phục hồi trên hạ tầng đại diện.
Tình huống giả định để luyện phân tích, không phải kết quả đo.
Giả sử node1 có A:1–12 và node2 có A:1–10 cùng B:1–3. Nhìn 12 lớn hơn 10 không cho biết node1 có các giao dịch B hay không. Hai tập này phân kỳ: node1 thiếu B:1–3, node2 thiếu A:11–12. Không có seed superset theo dữ kiện đó.
Giữ cả hai bản, xác minh B phát sinh từ đâu và tác động dữ liệu nghiệp vụ. View-change GTID và lịch sử topology có thể cần được xét riêng theo manual. Không thêm empty transaction chỉ để phép so GTID trả kết quả mong muốn; việc đó không copy row đã thiếu.
Nếu một partition khác vẫn có khả năng ghi, fencing phải được xác minh trước mọi bước chọn seed/force. Lệnh ping thất bại từ một máy quan sát không chứng minh partition đó đã dừng; dùng cơ chế hạ tầng và người chịu trách nhiệm để kiểm tra.
Sau lựa chọn recovery được phê duyệt, nghiệm thu nên gồm dữ liệu mẫu có khóa nghiệp vụ, schema, role và đường ứng dụng. Báo cáo phần dữ liệu không xác minh được, RPO thực và quyết định chấp nhận rủi ro. Một cluster trở lại ONLINE có thể vẫn cần đối soát nghiệp vụ và điều tra nguyên nhân trước khi đóng sự cố.
Phạm vi tham chiếu là tài liệu theo phiên bản ghi trong bài. Khi áp dụng, đối chiếu model triển khai, bản patch và quyền đang dùng; các ví dụ chưa được kiểm thử trên máy chủ thật.
Tiếp tục theo mạch kiến thức:
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
Dùng MySQL CLI có kiểm chứng: xác nhận server, TLS, account, role và tác động của KILL hoặc SET PERSIST trước khi quản trị.
Chọn mysqldump, MySQL Shell hoặc physical backup theo RPO/RTO; kiểm tra tính nhất quán, GTID, binlog và nghiệm thu bằng restore riêng.
Tối ưu MySQL bằng baseline, query digest, EXPLAIN và số đo bộ nhớ/I/O. Hiểu redo, dedicated server và tác động của từng thay đổi.