MySQL
8 phút•23/10/2026
Bài 5: InnoDB Buffer Pool: cấp RAM theo tải, tránh OOM
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
#mysqlĐọc ngay
Giám sát InnoDB Cluster bằng trạng thái member, hàng đợi, host và latency ứng dụng; kiểm tra exporter, no-data và runbook trước tự động hóa.
CPU primary bình thường nhưng commit latency tăng, trong khi một secondary có hàng đợi apply dài dần. Một dashboard chỉ có CPU/RAM có thể bỏ lỡ nguyên nhân này. Giám sát cluster cần nối trạng thái nhóm với tốc độ xử lý và trải nghiệm ứng dụng.
Phần 6 dùng MySQL 8.4 Group Replication, Shell và hệ thu thập metrics tùy chọn. Ví dụ SQL là phép đọc; tên field, quyền và collector phải được kiểm tra theo bản cài, không phải bằng chứng đã đo hệ thống thật.
Lớp dịch vụ gồm tỷ lệ lỗi, commit/read latency và số kết nối. Lớp cluster gồm view, member role/state, recovery và queue. Lớp host gồm CPU, disk latency, memory pressure và network. Đồng bộ thời gian, đặt nhãn cluster/member và phân biệt lúc sự kiện xảy ra với lúc collector nhận.
Một node ONLINE không đồng nghĩa toàn bộ ứng dụng khỏe; một exporter up không đồng nghĩa SQL scrape thành công. Ghi rõ nguồn dữ liệu để không gộp metric bị thiếu thành giá trị zero. Monitoring cũng phải hoạt động khi node primary mất.
SELECT member_id, member_host, member_port,
       member_state, member_role, member_version
FROM performance_schema.replication_group_members;

SELECT member_id, count_transactions_in_queue,
       count_conflicts_detected,
       count_transactions_remote_in_applier_queue
FROM performance_schema.replication_group_member_stats;
Đọc từ member cụ thể, ghi nguồn và timestamp vì các máy có thể có góc nhìn khác nhau khi partition. ONLINE, RECOVERING, ERROR và UNREACHABLE là đầu mối phân tích, không phải lệnh xử lý tự động. Queue đang chờ là gauge; counter tích lũy phải lấy delta/rate với reset được xét tới.
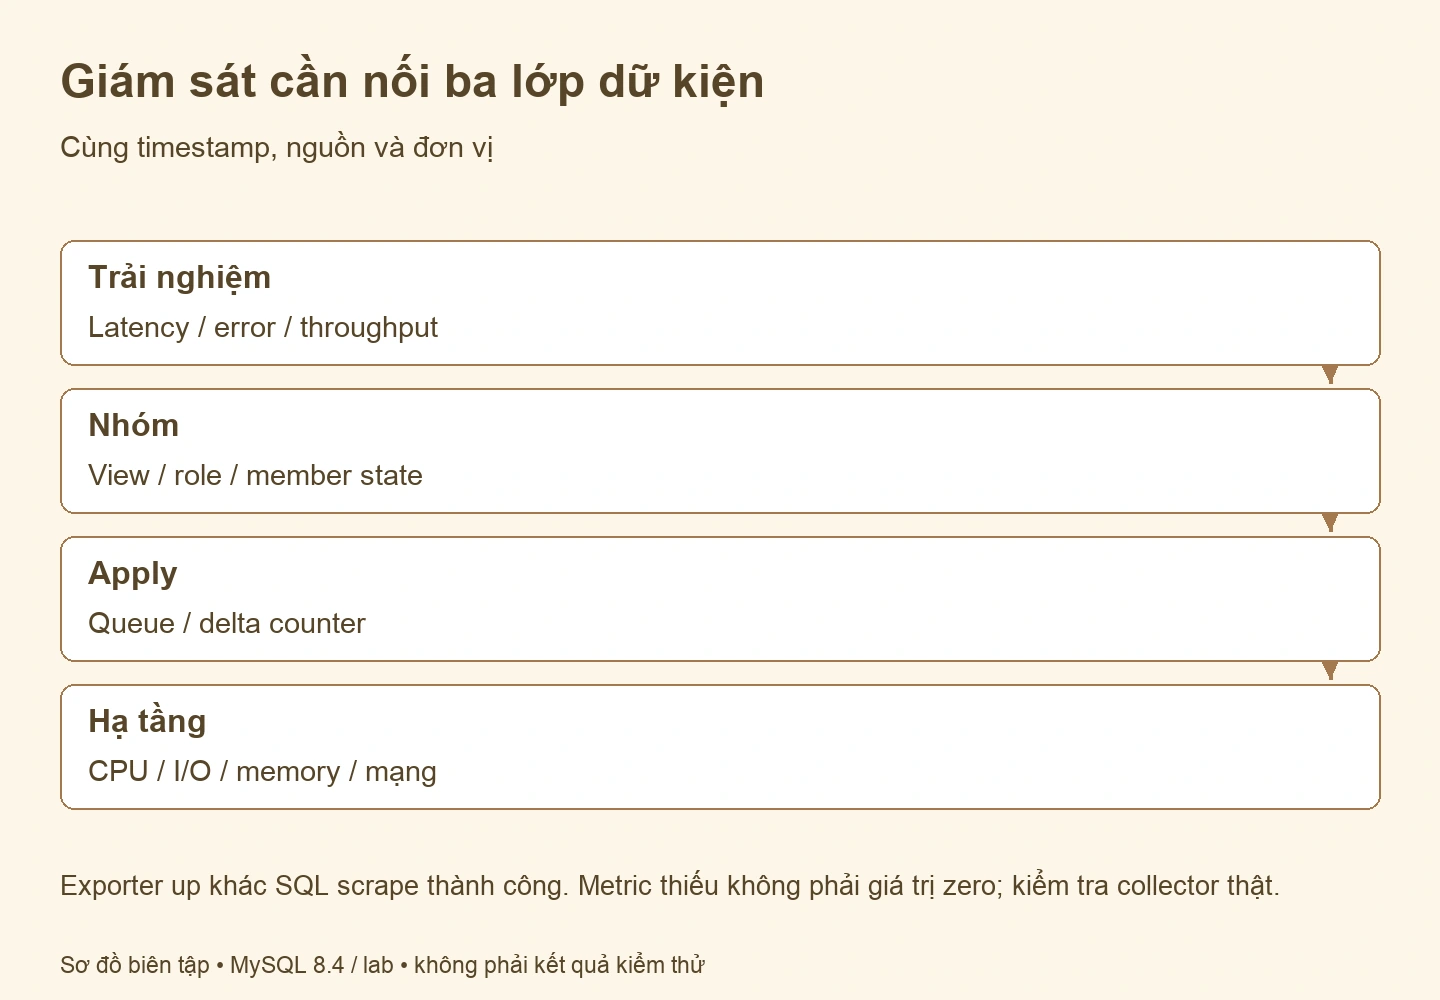
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Hàng đợi tăng có thể do apply chậm, transaction lớn, lock, I/O hoặc tốc độ nhận vượt khả năng xử lý. Flow control phụ thuộc mode và threshold thực, không có ngưỡng “vài chục nghìn” đúng cho mọi nhóm. Đọc option/variables cùng xu hướng queue và latency.
Không đặt replica_parallel_type cũ vào 8.4 hoặc tăng workers lên tám để “hết lag”. Workload tuần tự và hot row không tự song song hóa. Một thay đổi concurrency còn tiêu thêm CPU/RAM và có thể đổi cạnh tranh tài nguyên; thử có baseline và rollback.
var cluster = dba.getCluster('labCluster');
cluster.describe();
cluster.status({extended: 1});
Chạy trong session Shell JavaScript đã kết nối instance của cluster và có quyền đọc phù hợp. Lưu primary, role, trạng thái, cảnh báo và version. Đối chiếu với membership SQL và log tại thời điểm sự cố; một status đọc sau khi phục hồi có thể không còn dấu vết nguyên nhân.
Không chỉ đếm ONLINE rồi suy chắc mất quorum từ một observer. Alert giảm redundancy hữu ích khi còn quorum nhưng đã mất khả năng chịu thêm lỗi. Cần phân biệt cluster unhealthy, member unreachable từ monitoring và metrics stale.
mysqld_exporter có flags và cách cấp credential thay đổi theo release. Đọc README/help của binary được pin. Không tái dùng Environment=DATA_SOURCE_NAME hoặc bịa tên collector rồi kỳ vọng có metric. Dùng config file bảo vệ quyền theo hướng dẫn release, không đặt secret trong unit công khai.
mysqld_exporter --version
mysqld_exporter --help
Kiểm tra từng collector có hỗ trợ field bạn cần không. Nếu không có Group Replication metric mong muốn, chọn giải pháp/query collector phù hợp hoặc viết phép thu thập được kiểm thử, thay vì import dashboard và cho rằng ô trống là node tốt. Quyền account exporter phải khớp các truy vấn thực sự dùng.
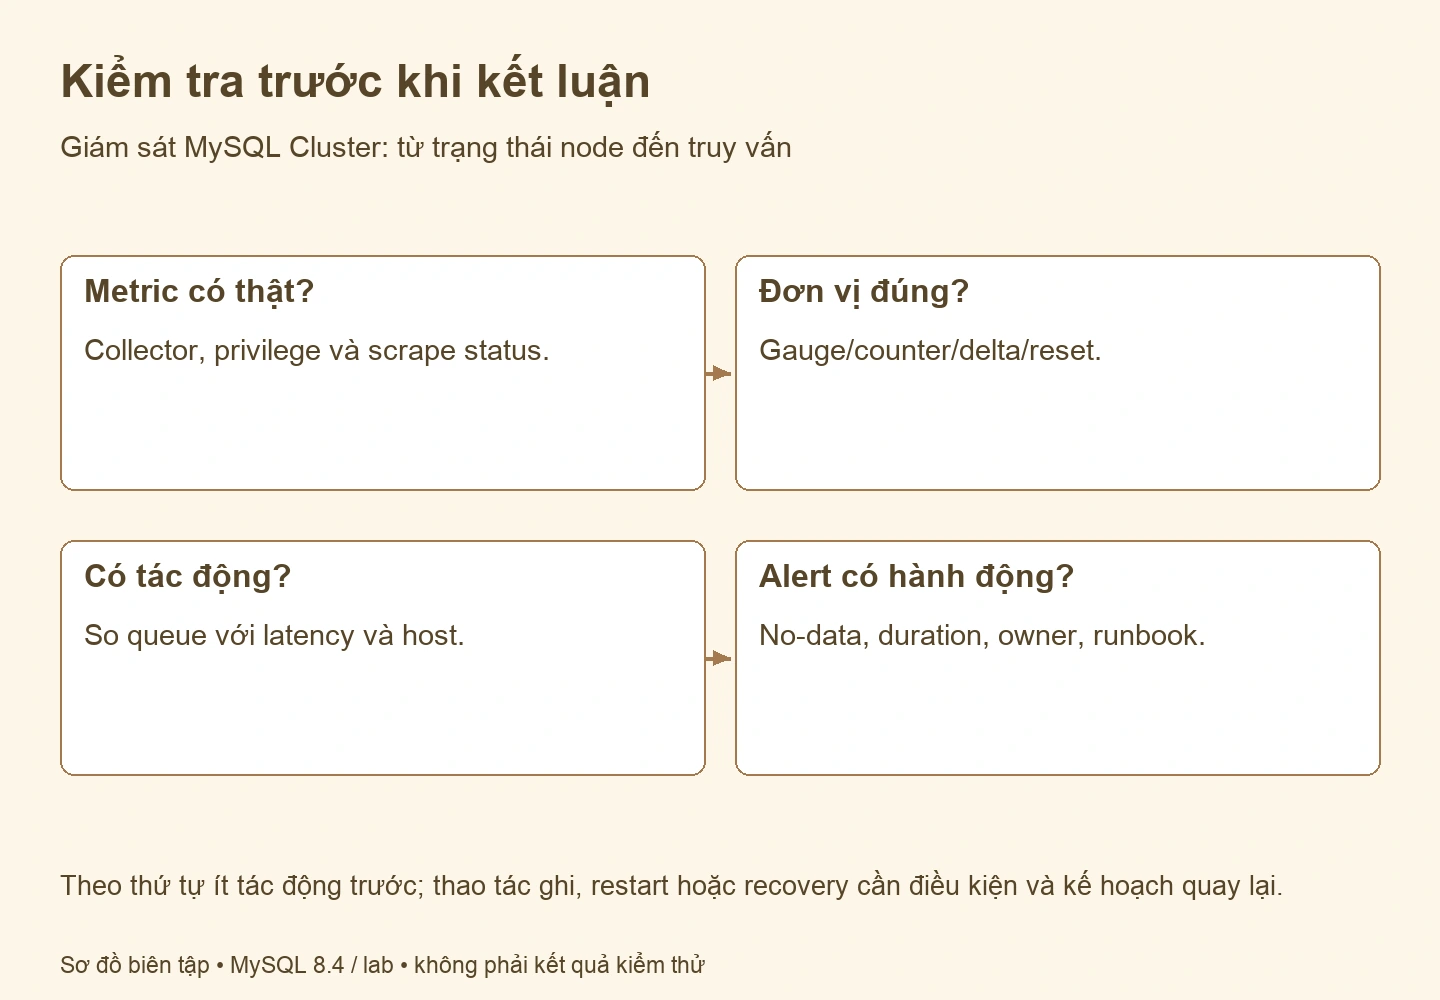
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Thiết kế alert cho mất member, đổi primary, recovery kéo dài, queue tăng có tác động, dung lượng sắp hết và scrape stale. Mỗi alert cần khoảng duy trì, severity, nhóm nhận, runbook và điều kiện hết lỗi. Ngưỡng lab có thể minh họa nhưng production phải dựa baseline/SLO.
Dashboard ID không phải bảo đảm tương thích label/collector. Kiểm tra tên series, đơn vị, rate window và reset. Thử ngắt một target lab để thấy no-data, thử một lỗi có kiểm soát để xác nhận cảnh báo đi được tới người trực và không chứa credential.
Hồ sơ sự cố nên có timeline ứng dụng, view/role theo member, queue/rate trong cùng cửa sổ, log và thay đổi gần nhất. Một snapshot không đủ chứng minh nhân quả; đối chiếu trước/sau và giả thuyết khác như storage throttling hoặc backup.
Checklist: collector có thật, credential được bảo vệ, đơn vị đúng, cảnh báo no-data, test delivery, runbook có giới hạn. Phần automation tiếp theo bắt đầu bằng tác vụ đọc trạng thái, không tự động force quorum hoặc kill query chỉ vì một alert.
Tình huống giả định để luyện phân tích, không phải kết quả đo.
Giả sử process exporter vẫn trả HTTP nhưng account bị thu hồi quyền hoặc collector bắt đầu lỗi. Nếu dashboard thay mọi missing series bằng zero, hàng đợi có thể trông bằng không và gây kết luận sai. Cần theo dõi scrape error và freshness độc lập với metric nghiệp vụ.
Xác định release exporter, danh sách collector thực và quyền account. Chạy một phép scrape lab có giới hạn, xem log và field được xuất. Không sửa bằng cách cấp ALL rồi bỏ qua privilege thiếu; chỉ cấp đúng quyền cho truy vấn được chọn và kiểm tra lại.
Thử no-data và target down như hai tình huống riêng. Alert cần đủ nhãn để người trực biết node nào, timestamp cuối cùng và runbook phù hợp. Đừng dựa một panel tổng hợp để tự force quorum hoặc restart member.
Sau khi đường thu thập phục hồi, kiểm tra counter reset và cửa sổ rate để tránh tạo spike giả. Dữ liệu monitoring bị mất trong thời gian sự cố phải được ghi là khoảng trống quan sát, không được nội suy thành thời gian cluster khỏe. Đối chiếu log và metrics ứng dụng khi phân tích nguyên nhân.
Phạm vi tham chiếu là tài liệu theo phiên bản ghi trong bài. Khi áp dụng, đối chiếu model triển khai, bản patch và quyền đang dùng; các ví dụ chưa được kiểm thử trên máy chủ thật.
Tiếp tục theo mạch kiến thức:
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
Dùng MySQL CLI có kiểm chứng: xác nhận server, TLS, account, role và tác động của KILL hoặc SET PERSIST trước khi quản trị.
Chọn mysqldump, MySQL Shell hoặc physical backup theo RPO/RTO; kiểm tra tính nhất quán, GTID, binlog và nghiệm thu bằng restore riêng.
Tối ưu MySQL bằng baseline, query digest, EXPLAIN và số đo bộ nhớ/I/O. Hiểu redo, dedicated server và tác động của từng thay đổi.