MySQL
8 phút•23/10/2026
Bài 5: InnoDB Buffer Pool: cấp RAM theo tải, tránh OOM
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
#mysqlĐọc ngay
Tạo InnoDB Cluster từ seed đúng, thêm từng member, chọn clone/incremental và kiểm tra topology trước khi đo failover qua ứng dụng.
Tạo được cluster object trên một seed chưa có nghĩa cụm đã chịu được mất một server. Cần thêm member, xác nhận recovery hoàn tất, kiểm tra vai trò và thử ứng dụng qua đường kết nối dự kiến.
Phần 4 dùng ba node MySQL 8.4 đã qua pre-check, account clusteradmin và tên labCluster. Đây là lab mới, single-primary; không dùng lệnh tạo/clone để nhập một database production đang có dữ liệu vào nhóm mà chưa có kế hoạch.
mysqlsh --mysql --js clusteradmin@mysql-node1:3306var cluster = dba.createCluster('labCluster');createCluster dùng instance của session hiện tại làm seed và tạo metadata cần thiết. Xác nhận hostname/version/account trước lệnh. Dữ liệu từ seed là nền để provision member khác; chọn nhầm seed không phải một lỗi có thể chữa bằng việc thêm node tùy ý.
Lưu cấu hình và backup trước khi tạo, kể cả khi dự định chỉ dùng lab. Không xóa schema metadata hay chạy bootstrap Group Replication thủ công song song với AdminAPI để vượt lỗi.
Communication stack, consistency và timeout phải phù hợp bản Server/Shell và mô hình mạng. Không dùng ipAllowlist của XCOM để thay authentication/firewall trong MYSQL stack. Nếu không rõ stack, đọc cluster.options() và biến server trước khi mở cổng.
cluster.options();
cluster.status({extended: 1});
Không ép EVENTUAL hoặc expelTimeout rất ngắn từ một ví dụ khác. Timeout bao gồm cơ chế phát hiện, nghi ngờ và loại member; một con số không đại diện tổng thời gian failover ứng dụng. Chính sách quá gấp có thể gây churn khi mạng chập chờn.
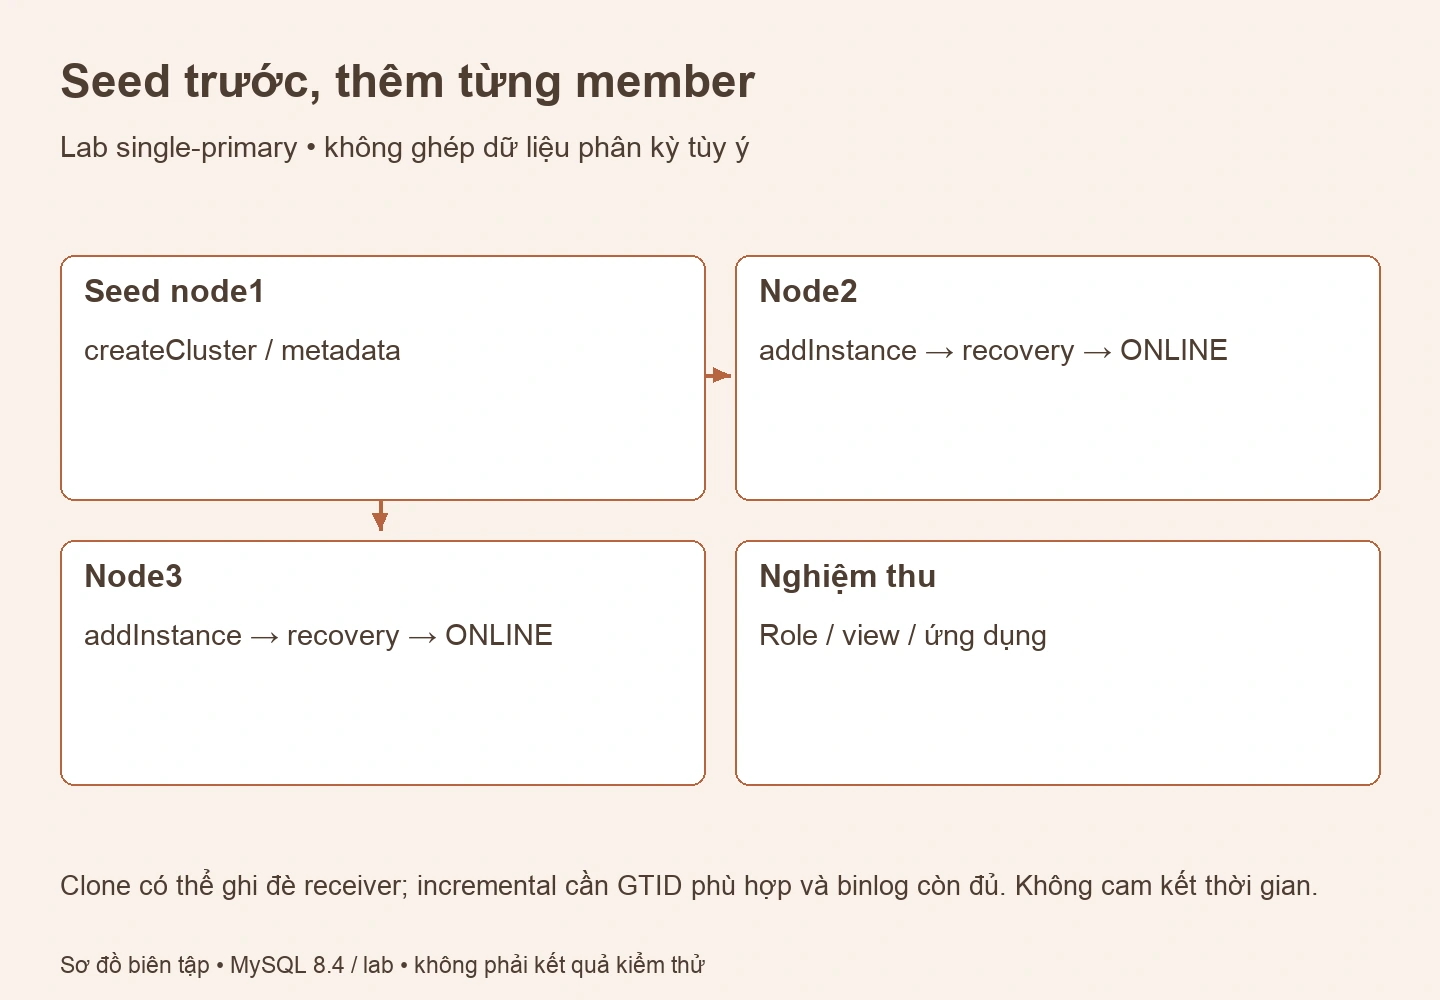
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
cluster.addInstance('clusteradmin@mysql-node2:3306');
cluster.status({extended: 1});
Đọc lựa chọn recovery được Shell đưa ra. Chỉ thêm node3 sau khi node2 đạt trạng thái mong đợi và tài nguyên còn đủ. Không chạy hai lần add cho cùng instance chỉ vì lần đầu chậm; theo dõi tiến trình và metadata trước retry.
cluster.addInstance('clusteradmin@mysql-node3:3306');Tốc độ phụ thuộc dữ liệu, disk, mạng và tải donor. Một ví dụ prompt không bảo đảm mọi môi trường có cùng lựa chọn hoặc cùng default. Nếu node có dữ liệu khác nguồn, dừng để bảo toàn và đối chiếu GTID thay vì luôn chọn C.
Clone copy trạng thái donor sang receiver và có thể xóa dữ liệu sẵn có ở receiver. Nó cần tương thích phiên bản/nền tảng theo manual cùng đủ disk và quyền. Thời gian không chỉ bị giới hạn bởi băng thông NIC.
Incremental dùng giao dịch còn thiếu khi tập GTID có quan hệ phù hợp và donor còn binlog cần thiết. Receiver trống GTID chưa chứng minh dữ liệu sạch hoặc toàn bộ lịch sử đã được bật GTID. Không đặt gtidSetIsComplete=true chỉ để bỏ câu hỏi tương tác.
cluster.describe();
cluster.status({extended: 1});
Mục tiêu của lab là ba member ONLINE, một PRIMARY, hai SECONDARY, các địa chỉ quảng bá đúng và không có cảnh báo chưa giải thích. Đồng thời kiểm tra read_only/super_read_only trên từng instance theo role. Lưu timestamp vì view thay đổi theo thời gian.
Status thành công không thay application write/read test hoặc backup restore. Nếu RECOVERING kéo dài, xem log recovery, donor và I/O; nếu UNREACHABLE, phân biệt lỗi tới máy quản trị với lỗi trong group. Không force remove chỉ để bảng trạng thái trông xanh.
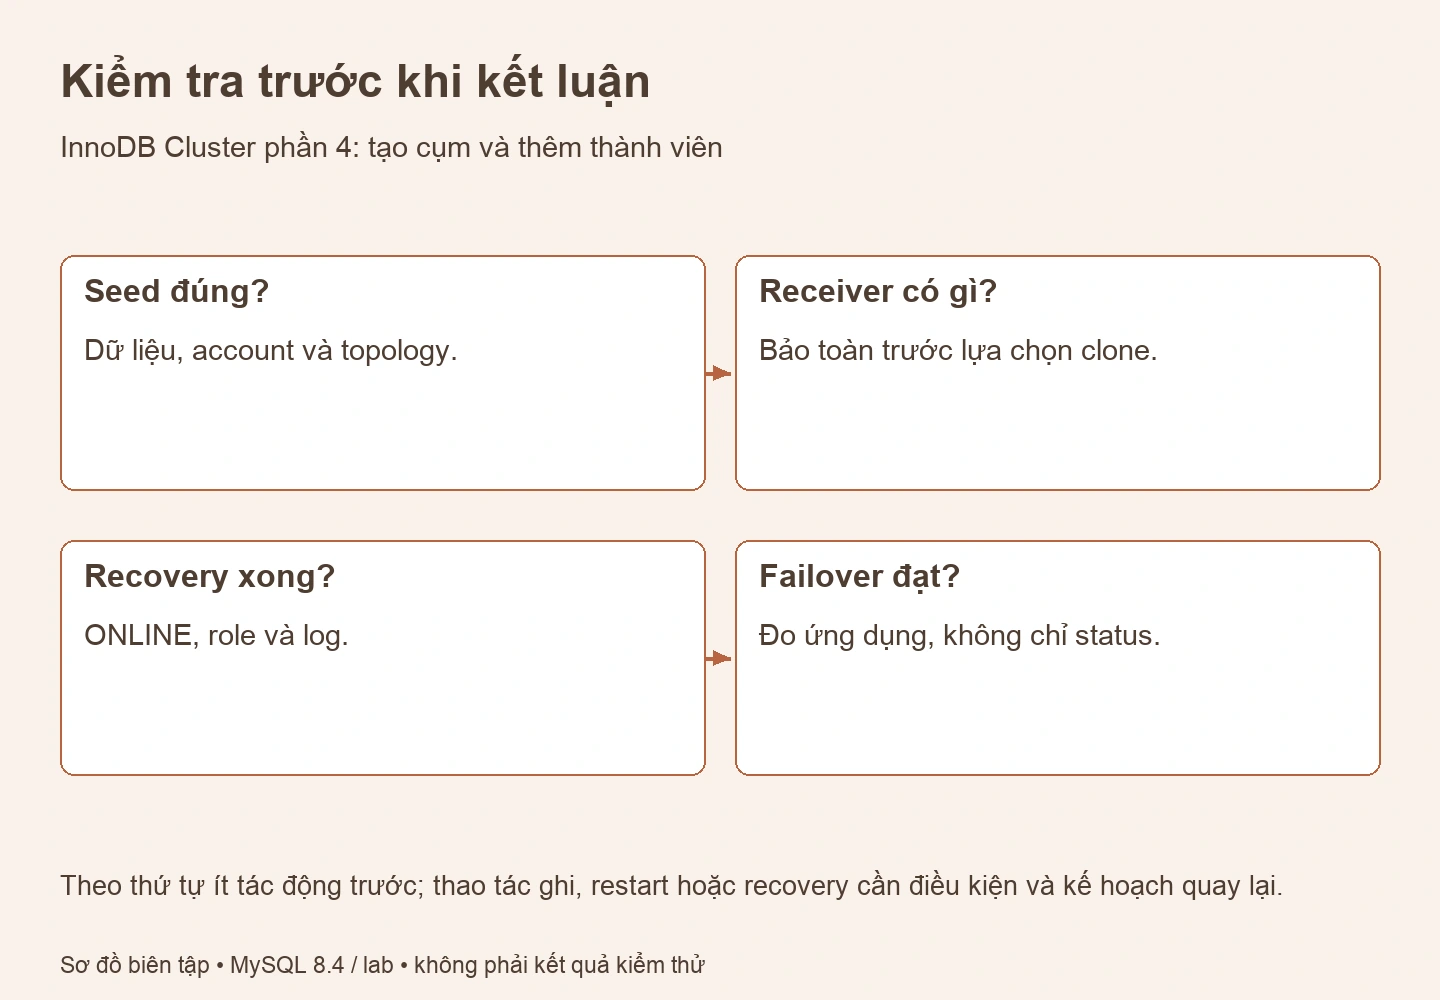
Cuộn ngang hoặc chạm sơ đồ để mở bản đầy đủ. Hình được biên tập, không phải ảnh chụp kiểm thử.
Chỉ diễn tập mất primary trong lab hoặc maintenance đã phê duyệt, có backup, monitoring và rollback. Ghi thời điểm phát hiện, election, Router nhận role mới, client reconnect và nghiệp vụ phục hồi. systemctl stop là dừng có kiểm soát, không đại diện mọi kiểu crash hoặc network partition.
Phiên cũ có thể lỗi; transaction chưa rõ kết quả cần xử lý idempotency. Không bảo đảm dưới ba giây hoặc không gián đoạn. Khi member cũ quay lại, xác minh recovery/rejoin theo cấu hình và trạng thái thật, không mặc định nó luôn tự trở thành secondary thành công.
Checklist: đúng seed, đúng dữ liệu receiver, ba member ONLINE, một writer, consistency đã hiểu, status/log đã lưu và có kế hoạch backup. Mọi phép thử ghi phải dùng schema lab với khóa nhận diện giao dịch, tránh sinh dữ liệu vô danh khó đối chiếu.
Phần Router tiếp theo giữ ứng dụng khỏi phụ thuộc địa chỉ một primary cụ thể. Router cải thiện đường kết nối, nhưng không tạo quorum hoặc phục hồi transaction dang dở. Đừng kết thúc nghiệm thu tại việc object cluster tồn tại.
Tình huống giả định để luyện phân tích, không phải kết quả đo.
Giả sử addInstance chưa kết thúc hoặc status vẫn RECOVERING. Đầu tiên xác định có job recovery đang chạy không và nó dùng clone hay incremental, thay vì gửi lại addInstance. Một lượng dữ liệu lớn có thể khiến tiến trình hợp lệ kéo dài.
Xem error log hai phía, donor, disk free, network và tải cùng lúc. Với incremental, kiểm tra binlog cần thiết còn có và tập GTID receiver phù hợp. Với clone, kiểm tra compatibility cùng giai đoạn copy/restart. Bất cứ yêu cầu ghi đè nào cũng cần bảo toàn dữ liệu receiver trước.
Nếu có lỗi, lưu report rồi giải quyết điều kiện cụ thể. Không removeInstance force để “dọn trạng thái” khi chưa biết tool và server đang làm gì. Recovery bị ngắt có thể cần thủ tục tiếp tục hoặc provision lại; chọn theo manual và bằng chứng thật.
Chỉ thêm node3 sau khi kết quả node2 rõ ràng. Hoàn tất lab cần ba member ONLINE cùng một view mong đợi, role đúng, endpoint hoạt động và dữ liệu nghiệp vụ kiểm chứng. Không suy từ việc node2 ping được hoặc CPU thấp rằng nó đã bắt kịp.
Phạm vi tham chiếu là tài liệu theo phiên bản ghi trong bài. Khi áp dụng, đối chiếu model triển khai, bản patch và quyền đang dùng; các ví dụ chưa được kiểm thử trên máy chủ thật.
Tiếp tục theo mạch kiến thức:
Phân bổ InnoDB Buffer Pool bằng ngân sách bộ nhớ và số đo workload; kiểm tra chunk, warm-up, NUMA và hit ratio trước khi thay cấu hình.
Dùng MySQL CLI có kiểm chứng: xác nhận server, TLS, account, role và tác động của KILL hoặc SET PERSIST trước khi quản trị.
Chọn mysqldump, MySQL Shell hoặc physical backup theo RPO/RTO; kiểm tra tính nhất quán, GTID, binlog và nghiệm thu bằng restore riêng.
Tối ưu MySQL bằng baseline, query digest, EXPLAIN và số đo bộ nhớ/I/O. Hiểu redo, dedicated server và tác động của từng thay đổi.