Nginx
6 phút•22/10/2026
Bài 9: Di trú NGINX từ CentOS sang Rocky Linux 9
Dựng máy chủ mới, kiểm tra cấu hình và SELinux, thử lưu lượng trước cutover; chuẩn bị rollback khi chuyển NGINX từ CentOS Linux đã hết hỗ trợ.
#centosĐọc ngay
Thiết lập upstream, kiểm tra lỗi thụ động và giới hạn retry; phân biệt định tuyến theo IP, cookie và lưu session tập trung trong cụm backend.
Trước khi bắt đầu. Bài này tập trung cấu hình và kiểm chứng cân bằng tải. Nếu cần chọn thuật toán theo loại ứng dụng, đọc bài so sánh riêng; cân bằng tải không tự loại bỏ điểm lỗi đơn tại chính máy NGINX.
Trong các hệ thống phần mềm có lưu lượng truy cập lớn, một máy chủ đơn lẻ (Single Point of Failure - SPoF) không thể đáp ứng được khối lượng công việc ngày càng gia tăng và luôn tiềm ẩn nguy cơ sập toàn bộ dịch vụ khi xảy ra sự cố phần cứng hoặc bảo trì ứng dụng.
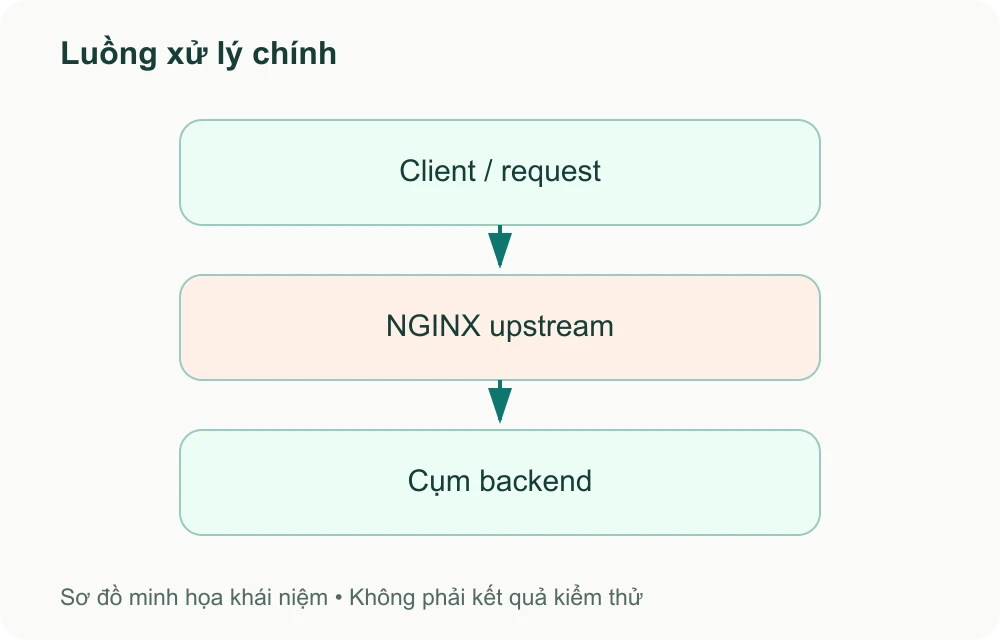
Cân bằng tải đặt NGINX trước một nhóm backend để phân phối request. Khả năng chuyển sang node khác phụ thuộc loại lỗi, cấu hình upstream và việc response đã gửi cho client hay chưa. Một NGINX đơn vẫn có thể là điểm lỗi đơn; HA cho lớp gateway là bài toán riêng.
NGINX hỗ trợ đa dạng các phương pháp phân phối lưu lượng tùy thuộc vào tính chất của ứng dụng:
Lưu lượng được luân chuyển tuần tự và đồng đều tới từng máy chủ theo danh sách. Phù hợp nhất cho các cụm máy chủ có cấu hình phần cứng tương đồng và các tác vụ có thời gian xử lý ngắn.
Cho phép gán chỉ số weight cho từng máy chủ. Máy chủ có cấu hình mạnh hơn (nhiều CPU/RAM hơn) sẽ được gán trọng số lớn hơn để tiếp nhận nhiều request hơn theo tỷ lệ:
upstream backend_cluster {
    server srv1.example.com weight=3; # Nhận 60% lưu lượng
    server srv2.example.com weight=2; # Nhận 40% lưu lượng
}least_conn)NGINX chuyển request tiếp theo tới máy chủ hiện đang xử lý số lượng kết nối đồng thời thấp nhất. Thuật toán này cực kỳ hiệu quả đối với các ứng dụng có thời gian xử lý tác vụ không đồng đều (như API xuất báo cáo nặng, render hình ảnh, streaming video).
upstream backend_cluster {
    least_conn;
    server srv1.example.com;
    server srv2.example.com;
}ip_hash)Địa chỉ IP của người dùng được sử dụng làm khóa băm (Hash key) để đảm bảo toàn bộ request từ cùng một địa chỉ IP luôn được gửi tới cùng một máy chủ backend cố định. Đây là giải pháp đơn giản nhất để duy trì phiên đăng nhập (Session) khi ứng dụng backend chưa có Redis lưu trữ session tập trung.
upstream backend_cluster {
    ip_hash;
    server srv1.example.com;
    server srv2.example.com;
}hash)Cho phép quản trị viên băm theo bất kỳ biến văn bản nào của request (ví dụ theo URI, query parameter hoặc header):
upstream backend_cluster {
    # Băm theo đường dẫn URI kèm tính năng phân tán ổn định consistent hashing
    hash $request_uri consistent;
    server srv1.example.com;
    server srv2.example.com;
}Để xây dựng một hệ thống có khả năng tự phục hồi, khối upstream cần được trang bị các chỉ thị bảo vệ và kiểm soát ngưỡng lỗi:
upstream app_servers {
    least_conn;

    # Máy chủ chính 1: Tối đa 200 kết nối đồng thời, nếu có 3 lần lỗi được tính trong 30 giây sẽ tạm ngưng 30 giây
    server 10.0.0.11:8080 weight=3 max_conns=200 max_fails=3 fail_timeout=30s;

    # Máy chủ chính 2
    server 10.0.0.12:8080 weight=2 max_conns=150 max_fails=3 fail_timeout=30s;

    # Máy chủ dự phòng (Backup Server): Chỉ nhận lưu lượng khi TẤT CẢ các máy chủ chính đều sập
    server 10.0.0.99:8080 backup;

    # Đánh dấu máy chủ đang được bảo trì phần mềm (không nhận bất kỳ lưu lượng nào)
    server 10.0.0.13:8080 down;

    # Duy trì kết nối TCP Keepalive sẵn sàng với backend để tăng tốc độ phản hồi
    keepalive 32;
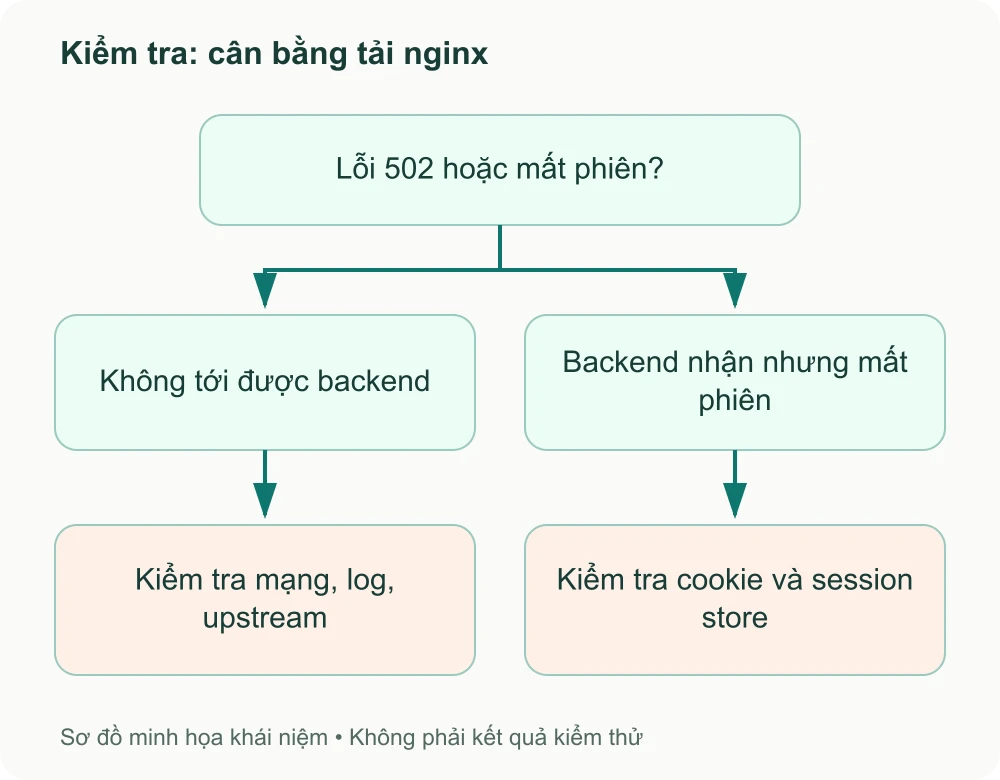
}Trong các ứng dụng Stateful (như giỏ hàng thương mại điện tử hoặc ứng dụng lưu thông tin đăng nhập trong RAM/file cục bộ của máy chủ), nếu người dùng gửi request đầu tiên vào Server A nhưng request thanh toán tiếp theo lại bị chuyển sang Server B, phiên làm việc sẽ bị mất và người dùng bị văng ra khỏi hệ thống.
Có 3 hướng tiếp cận để xử lý vấn đề này:
hash $cookie_sessionid consistent; để băm theo mã Cookie của ứng dụng, đảm bảo tính phân tán đồng đều hơn nhiều so với IP Hash.least_conn để tối ưu hóa tải mà không cần lo lắng về việc mất phiên làm việc.Tạo file cấu hình hoàn chỉnh /etc/nginx/conf.d/load-balancer.conf:
upstream backend_cluster {
    least_conn;
    server 10.0.0.11:8080 max_fails=2 fail_timeout=10s;
    server 10.0.0.12:8080 max_fails=2 fail_timeout=10s;
    server 10.0.0.13:8080 backup;
    keepalive 32;
}

server {
    listen 80;
    server_name lb.example.com;
    return 301 https://$host$request_uri;
}

server {
    listen 443 ssl;
    http2 on;
    server_name lb.example.com;

    ssl_certificate /etc/letsencrypt/live/lb.example.com/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/lb.example.com/privkey.pem;

    # Cấu hình chuyển hướng và xử lý lỗi
    location / {
        proxy_pass http://backend_cluster;
        proxy_http_version 1.1;
        proxy_set_header Connection "";

        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;

        # Tự động thử lại máy chủ backend khác nếu gặp lỗi kết nối hoặc HTTP 500, 502, 503, 504
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503 http_504;
        proxy_next_upstream_tries 3;
        proxy_next_upstream_timeout 10s;

        proxy_connect_timeout 5s;
        proxy_send_timeout 30s;
        proxy_read_timeout 30s;
    }
}
Lưu ý quan trọng cho Rocky Linux / RHEL 9 (SELinux):
Trên hệ điều hành có bật SELinux như Rocky Linux hoặc AlmaLinux, NGINX bị chặn mặc định khi thực hiện kết nối mạng ra bên ngoài tới máy chủ backend. Bạn cần chạy lệnh mở quyền cho SELinux:
sudo setsebool -P httpd_can_network_connect 1Trên bản NGINX Open Source, hệ thống sử dụng cơ chế Passive Health Checks: NGINX chỉ phát hiện máy chủ backend chết khi một request thực tế của người dùng gửi tới máy chủ đó và bị timeout hoặc lỗi. Khi số lần lỗi đạt đến ngưỡng max_fails, NGINX sẽ tạm thời gỡ bỏ máy chủ đó trong khoảng thời gian fail_timeout.
proxy_next_upstream chỉ thử node khác khi đáp ứng điều kiện của module. Không thể chuyển tiếp lại nếu response đã được gửi một phần. Request thay đổi dữ liệu có nguy cơ lặp thao tác; không bật retry non_idempotent nếu ứng dụng chưa có cơ chế chống trùng.
Sau khi reload NGINX (sudo nginx -t && sudo systemctl reload nginx), bạn có thể kiểm tra thuật toán cân bằng tải bằng cách chạy một vòng lặp curl từ máy trạm:
for i in {1..10}; do curl -s https://lb.example.com | grep "Server Hostname"; doneNếu thấy kết quả luân phiên hiển thị tên của các máy chủ backend (Node-01, Node-02), đã quan sát thấy phân phối request trong phép thử này; cần kiểm tra thêm lỗi node, phiên đăng nhập và log trước khi phục vụ production.
Ở bài tiếp theo, chúng ta sẽ mở rộng mô hình Reverse Proxy này để định tuyến cho các hệ thống Microservices hiện đại giao tiếp bằng giao thức hiệu năng cao gRPC.
Hash theo cookie chỉ ổn định khi ứng dụng đã cấp một cookie có giá trị và vòng đời phù hợp. Cookie rỗng, thay đổi khóa hoặc thay danh sách backend có thể làm request đổi node. Cookie hash không tự tạo, đồng bộ hay sao lưu session.
Các địa chỉ example.com, IP riêng và đường dẫn trong ví dụ cần thay theo môi trường thực tế. Các sơ đồ trong bài là minh họa khái niệm, không phải bằng chứng thử nghiệm trên hệ thống của bạn.
Trước khi áp dụng: sao lưu file cấu hình bị đổi, chạy sudo nginx -t, chỉ reload khi kiểm tra thành công, rồi xác nhận endpoint, error log và chức năng ứng dụng. Nếu lỗi xuất hiện, phục hồi file đã sao lưu, kiểm tra cú pháp và reload lại; không xóa hàng loạt cấu hình để thử.
Đọc tiếp: Cách chọn thuật toán cân bằng tải.
Dựng máy chủ mới, kiểm tra cấu hình và SELinux, thử lưu lượng trước cutover; chuẩn bị rollback khi chuyển NGINX từ CentOS Linux đã hết hỗ trợ.
Định tuyến dịch vụ gRPC qua NGINX, phân biệt kết nối TLS đến upstream, cấu hình timeout cho streaming và kiểm tra bằng grpcurl.
Chọn kho gói phù hợp, cài NGINX, mở cổng web và kiểm tra dịch vụ trên Ubuntu 24.04 hoặc Rocky Linux 9. Có lưu ý riêng cho Debian và SELinux.
Cấp chứng chỉ HTTPS với Certbot, kiểm tra DNS và HTTP-01, thử gia hạn tự động và cấu hình TLS phù hợp trước khi bật HSTS.