Linux Essentials 3.2: Tìm kiếm và trích xuất dữ liệu từ Tệp
Thực hành xử lý văn bản Linux bằng grep, cut, sort và uniq; hiểu pipe, ghi đè, nối thêm và phân biệt không khớp với lỗi đọc dữ liệu trong lab.
Một danh sách ticket cần được đọc theo cấu trúc
Bạn nhận bốn dòng ticket và cần biết có bao nhiêu yêu cầu đang mở theo từng nhóm. Tìm chữ OPEN ở bất kỳ đâu trong tệp có thể lấy nhầm phần mô tả; đếm số dòng sau một pipeline không kiểm tra cũng có thể bỏ qua lỗi đọc đầu vào. Bài này dùng dữ liệu nhỏ để bạn giải thích từng phép biến đổi, biết kết quả mong đợi và nhận ra khi điều kiện không còn phù hợp.
Bài thuộc mục tiêu 3.2 của Linux Essentials 010-160, đối chiếu nhóm 013.2 của 010-200. Mốc biên tập: 23/10/2026. Lab dùng Bash và các tiện ích văn bản trong image Ubuntu 26.04.1 LTS ARM64. Không xử lý log khách hàng hoặc dữ liệu production. Các ví dụ tạo và ghi tệp dưới thư mục tạm; tên và nội dung đều là fixture tự biên soạn.
Chuẩn bị đầu vào đủ nhỏ để kiểm tra bằng mắt
Mỗi dòng gồm mã ticket, trạng thái và nhóm, phân cách bằng dấu |. Dữ liệu không có trường chứa dấu phân cách, dòng nhiều dòng hoặc cơ chế quote kiểu CSV. Giới hạn này là một phần của bài: công cụ tách theo ký tự không tự trở thành parser của mọi định dạng bảng.
Bạn dự kiến thấy bốn bản ghi và số dòng 4. wc -l đếm ký tự xuống dòng, không xác nhận schema hoặc số đối tượng nghiệp vụ của một định dạng bất kỳ. Fixture được tạo bằng printf để mỗi bản ghi kết thúc bằng newline. Với tệp ngoài bài, cần kiểm tra cách kết thúc dòng và quy tắc định dạng trước khi gọi số đó là số ticket.
Dấu > trong khối tạo fixture có thể ghi đè tệp đích nếu tái sử dụng đường dẫn. Ở đây mktemp tạo thư mục mới để giới hạn tác động. Không thay đường dẫn bằng tệp log đang được ứng dụng ghi. Nếu đóng shell, ghi lại đường dẫn trước; biến lpi_text không tự tồn tại trong phiên mới.
stdin, stdout và stderr là các luồng khác nhau
Theo quy ước thông dụng, chương trình đọc dữ liệu từ standard input, ghi kết quả vào standard output và gửi thông báo chẩn đoán qua standard error. Chúng có các file descriptor 0, 1 và 2. Một chương trình cụ thể có thể có thêm nguồn dữ liệu hoặc cơ chế log, nên cần đọc tài liệu nếu bạn muốn thu đầy đủ mọi thông báo.
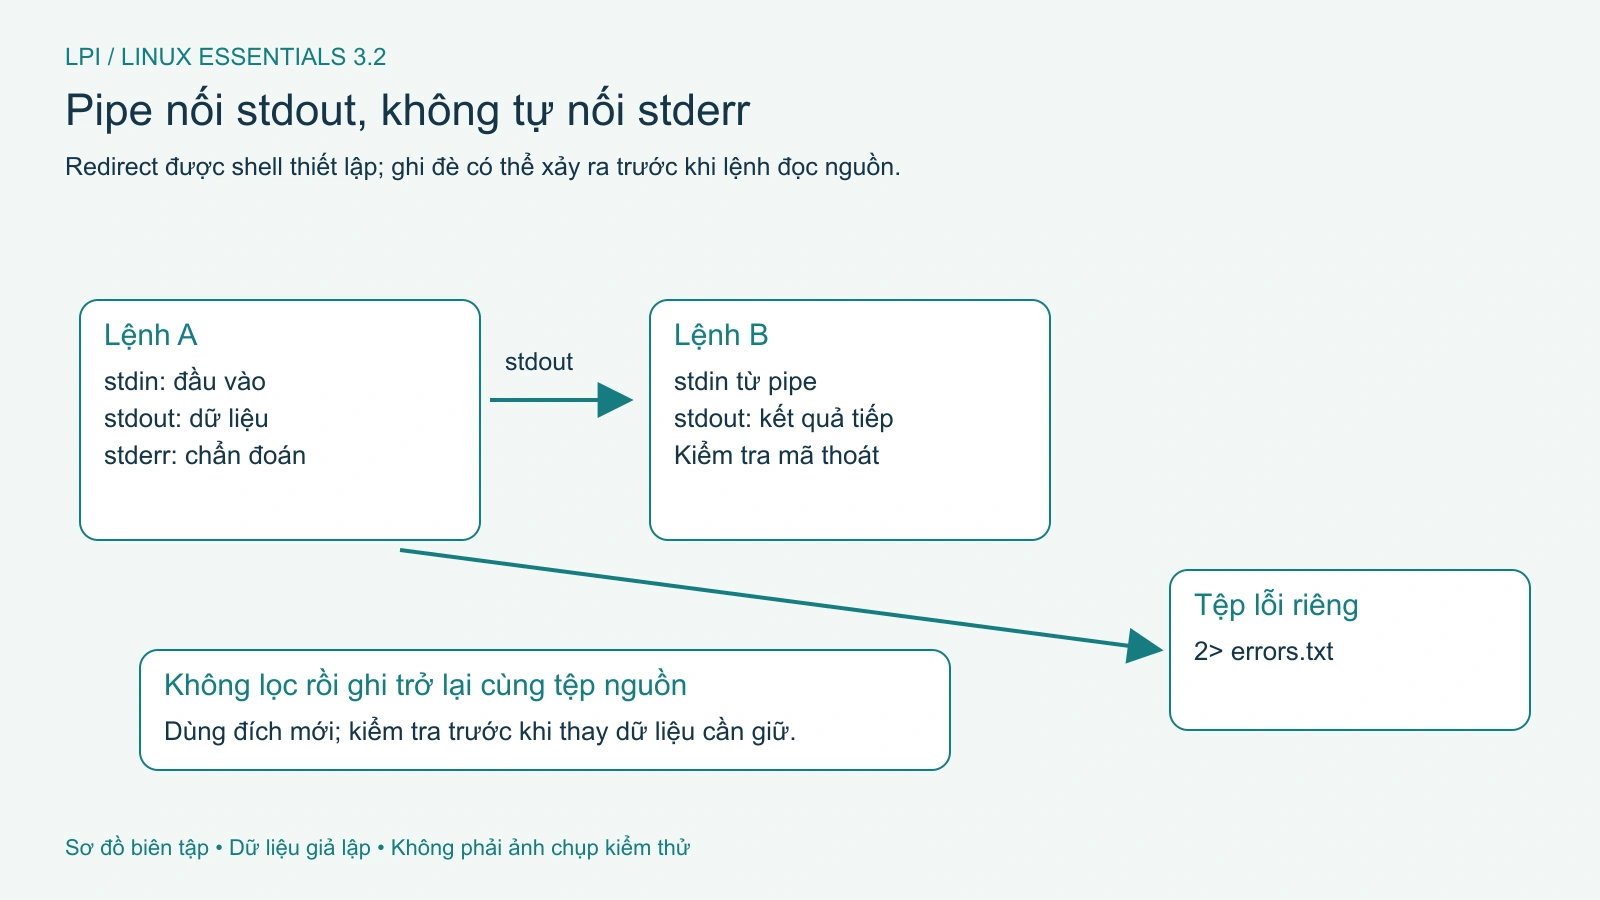
Pipe nối stdout của lệnh bên trái vào stdin của lệnh bên phải trong cách dùng mặc định. Nó không tự nối stderr. Điều này giúp giữ thông báo lỗi ngoài dữ liệu được xử lý tiếp, nhưng cũng có nghĩa một bản báo cáo cuối không chứa dòng lỗi không chứng minh tất cả bước trước đã thành công.
Trong ví dụ wc -l < tệp, shell mở tệp làm stdin của wc. Trong ví dụ cat tệp, chương trình cat tự mở đường dẫn được truyền như đối số. Hai cách có thể cho cùng dữ liệu trong tình huống đơn giản, nhưng nơi phát sinh lỗi mở tệp và cách thông báo có thể khác. Không cần thêm cat vào mọi pipeline nếu công cụ đã đọc trực tiếp tệp.
Hình 2. Pipe nối stdout; stderr và redirect cần được xử lý riêng. Mở hình để xem chi tiết.
Ghi đè và nối thêm phải được chọn có chủ ý
Dấu > mở đích để ghi và thường cắt ngắn nội dung cũ trước khi chương trình hoàn tất. Dấu >> nối thêm. Bài thử trên tệp riêng để bạn thấy khác biệt; không áp lên bản gốc cần giữ. Một chương trình lỗi sau khi shell mở đích vẫn có thể để lại tệp rỗng hoặc một phần dữ liệu.
Sau hai dòng đầu, tệp có new và appended. Sau lần ghi cuối, chỉ còn replacement. Đừng redirect một phép lọc trở lại chính tệp đầu vào trong cùng câu lệnh vì shell có thể cắt ngắn nó trước khi công cụ đọc. Với công việc thật, ghi sang tệp kết quả mới, kiểm tra rồi dùng quy trình thay thế có phục hồi phù hợp.
Thứ tự redirect cũng quan trọng khi bạn gộp stdout và stderr. Bài nhập môn giữ hai luồng ở hai tệp thay vì gộp mọi thứ rồi cố phân biệt lại. Không gửi stderr vào /dev/null như cách mặc định để làm một lệnh “sạch lỗi”; bạn có thể đang mất thông tin cần chẩn đoán.
Lọc đúng trường bằng biểu thức có điều kiện rõ
grep -E dùng extended regular expression. Ở mẫu dưới, ^ neo đầu dòng, [^|]+ khớp ít nhất một ký tự không phải dấu |, còn dấu phân cách literal được escape. Mẫu chọn trường thứ hai đúng OPEN trong cấu trúc fixture, không chỉ một từ xuất hiện đâu đó trong mô tả.
Kết quả dự kiến là T001, T003 và T004. Bạn cần đọc cả ba dòng để xác nhận trường trạng thái. Một biểu thức đúng cho fixture chưa đủ để xử lý dữ liệu có trường rỗng, delimiter trong nội dung hoặc trạng thái khác chuẩn. Nếu hệ thống xuất JSON hoặc CSV có quy tắc quote, dùng parser của định dạng đó thay vì kéo dài biểu thức đến mức khó kiểm tra.
Trong ERE, dấu . khớp một ký tự theo ngữ cảnh của engine; * lặp phần trước không hoặc nhiều lần; ? thường biểu diễn không hoặc một lần; lớp ký tự [] chọn tập ký tự. Dấu * ở đây không phải glob của shell. Quoting quanh mẫu giữ nó cho grep diễn giải. Đọc GNU grep manual cùng --help và phiên bản thực tế khi dùng tính năng ngoài ví dụ.
Lấy cột, sắp xếp và đếm các giá trị liền nhau
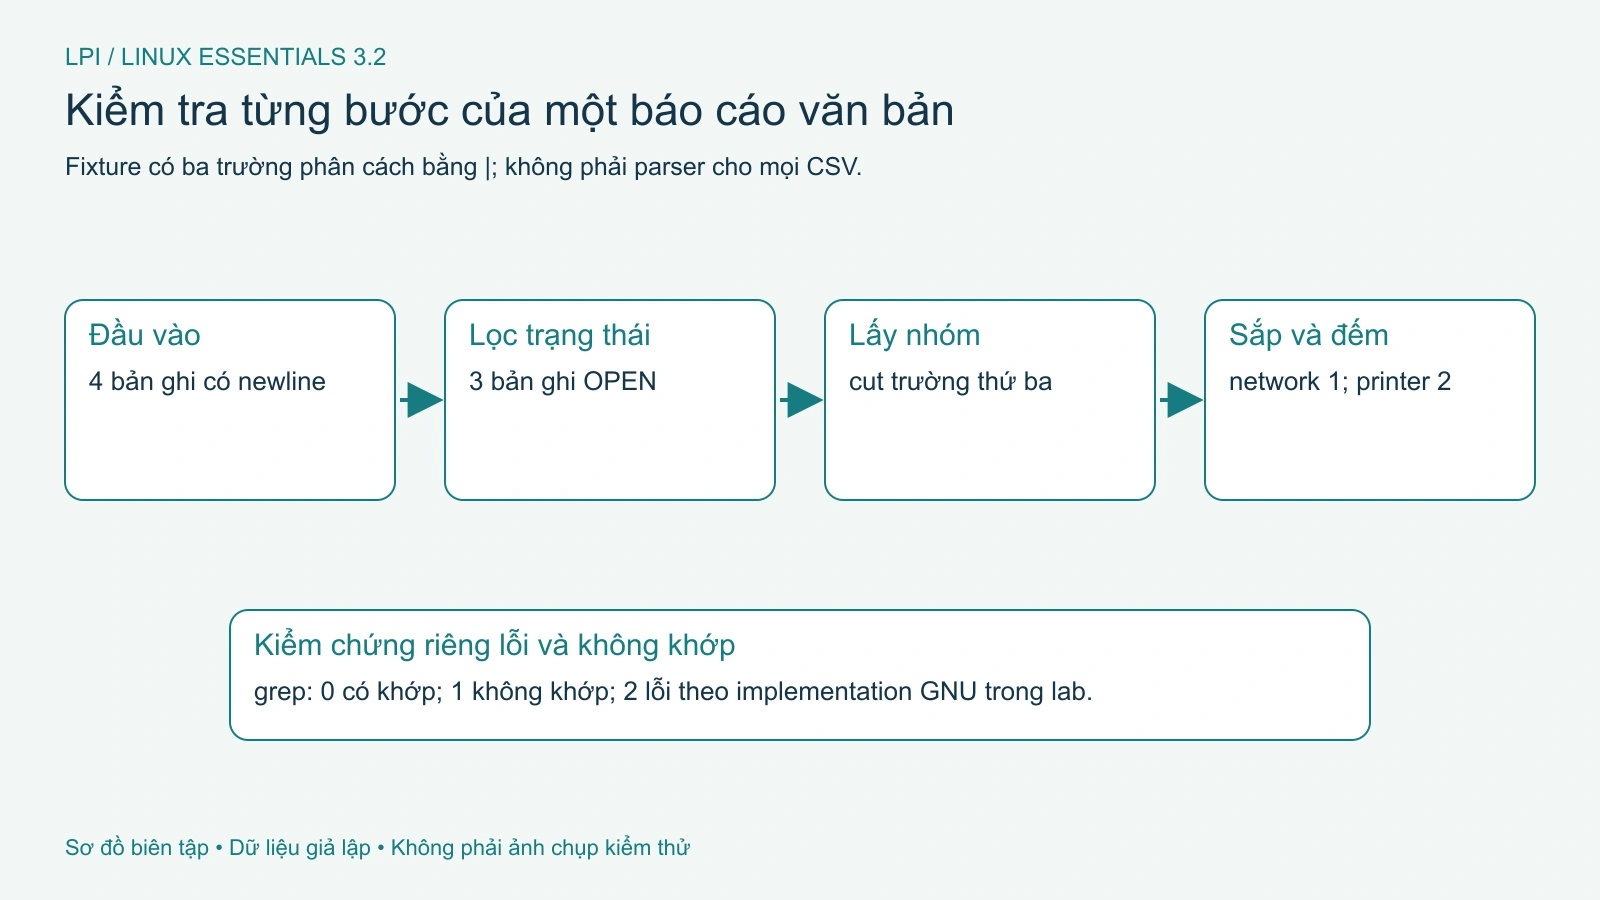
Sau khi đã lọc đúng, cut lấy trường nhóm bằng delimiter |. sort đưa các dòng cùng giá trị về cạnh nhau; uniq -c đếm nhóm dòng bằng nhau liền kề. Nếu bỏ sort, các lần lặp không đứng cạnh nhau có thể vẫn xuất hiện thành nhiều nhóm riêng.
Bạn dự kiến thấy network có 1 và printer có 2. Khoảng trắng căn cột trong đầu ra không phải phần của tên nhóm. Thứ tự sort có thể phụ thuộc locale; khi cần kết quả kiểm thử xác định với dữ liệu ASCII, đặt LC_ALL=C cho phạm vi phép thử. Điều đó không có nghĩa nên áp locale C cho mọi công việc sắp xếp tiếng Việt.
Dòng đầu vẫn có ba mục vì hai a không liền nhau; dòng sau còn hai giá trị. Đây là phép thử nhỏ giúp giải thích cơ chế thay vì học thuộc chuỗi sort | uniq. uniq không tự kiểm tra hai bản ghi có cùng ý nghĩa nghiệp vụ nếu cách viết khác chữ hoa, dấu cách hoặc mã hóa.
Hình 1. Lọc đúng trường rồi lấy nhóm, sắp xếp và đếm theo fixture. Mở hình để xem chi tiết.
Xem đầu, cuối và đọc từng phần
head và tail hữu ích khi muốn quan sát một phần tệp. Với fixture ngắn, dùng số dòng rõ ràng để bạn đoán được kết quả. Không suy từ vài dòng đầu rằng toàn bộ tệp có cùng schema. Dữ liệu lỗi có thể nằm ở giữa hoặc cuối, và các tệp đang được ghi có thể đổi ngay khi bạn đọc.
head -n 2 "$lpi_text/tickets.txt"
tail -n 1 "$lpi_text/tickets.txt"
Nếu có less, nó giúp đọc tương tác mà không đổ toàn bộ tệp lên terminal. Trong cấu hình phổ biến, / tìm và q thoát. Với tệp chứa dữ liệu riêng, tránh chụp cả màn hình để hỏi một lỗi nhỏ. Chỉ trích phần cần thiết đã loại thông tin nhạy cảm và nêu rõ đó là mẫu, không đưa log nội bộ vào bài công khai.
Không có kết quả khác với lỗi xử lý
grep thông thường phân biệt tìm thấy, không tìm thấy và lỗi bằng mã thoát. Với GNU grep, không khớp thường là 1, lỗi thường là 2. Đừng xem mọi mã khác 0 là cùng một loại lỗi hệ thống. Trong script, câu hỏi “không có ticket phù hợp” phải được tách khỏi “không đọc được tệp”.
if grep -E '^MISSING' "$lpi_text/tickets.txt"; then
  printf '%s\n' 'Có dòng khớp.'
else
  lpi_status=$?
  printf 'grep status=%s\n' "$lpi_status"
fi
Trong fixture này, status dự kiến là 1. Lưu $? ngay sau lệnh cần hỏi vì một lệnh tiếp theo sẽ thay giá trị đó. Mặc định Bash lấy trạng thái lệnh cuối cho pipeline; một lệnh ở đầu bị lỗi có thể bị che bởi lệnh cuối thành công. pipefail thay đổi cách tổng hợp trạng thái, nhưng vẫn cần thiết kế cách xử lý không khớp và lỗi theo nhiệm vụ.
Nghiệm thu bằng dữ liệu và giới hạn
Bạn đạt bài khi chứng minh được bốn bản ghi đầu vào, ba bản ghi OPEN và số nhóm 1 network, 2 printer. Tiếp theo, thay một trạng thái trong bản sao mới rồi dự đoán số đếm. Ghi cả lệnh, phiên bản và kết quả; không chỉ giữ ảnh của báo cáo cuối.
Tự kiểm tra: Vì sao cần sort trước uniq trong ví dụ? Vì uniq chỉ gom dòng trùng liền kề. Pipe có tự chuyển stderr sang lệnh sau không? Không trong cách dùng mặc định đã nêu. Dấu > có bảo đảm giữ nguồn nếu dùng lại cùng tên không? Không. Các câu trả lời này là nền tảng để chuyển sang script có kiểm tra đầu vào và trạng thái trả về ở bài tiếp theo.